核心结论:高端GPU单点依赖正被“结构性稀释”——推理侧国产替代已实质成立(2025年份额41%、2026Q1破55%),训练侧经“MoE×稀疏注意力×超节点”组合快速跟进;完全“终结”仍受先进制程产能、HBM供应与生态迁移三重约束,2026-2028年为决定性窗口期。
一 核心观点
核心命题:在高端GPU供给被地缘政治持续约束的背景下,中国AI产业能否依靠“算法侧架构创新(稀疏注意力/MoE)+供给侧国产芯片适配”的双轮降本路径,终结对英伟达高端GPU的单点依赖。
核心判断:单点依赖正在被“结构性稀释”——在推理侧已实质性突破,在训练侧正快速跟进,但“终结”仍受制于先进制程产能、HBM供应与软件生态三类硬约束,预计2026-2028年是中国算力自主化从“替代可用”走向“自主好用”的决定性窗口期。
核心观点一:高端GPU单点依赖的政策与市场基础已被双重削弱。政策端,美国出口管制自2022年10月首轮管制以来不断加码,H20于2025年4月起需许可证且无限期生效,直接导致英伟达在2026财年第一季度计提45亿美元费用;2025年12月H200虽获准对华销售(25%分成),但2026年8月披露的财报显示其对华收入占数据中心总收入不足1%,英伟达对华数据中心收入贡献已边缘化。市场端,IDC数据显示2025年中国AI加速卡市场总出货量约400万张,其中国产厂商合计出货约165万张、份额约41%,首次突破四成;英伟达份额降至约55%,较管制前宣称的约95%近乎腰斩。
核心观点二:稀疏注意力与MoE构成“算力节省”的算法双引擎,且已被工程与商业结果验证。MoE架构以“总参数承载知识容量、激活参数决定算力账单”的两本账机制,使DeepSeek-V3以278.8万H800 GPU小时(约557.6万美元)完成671B参数模型训练,仅为Llama 3.1 405B训练算力的约1/11;稀疏注意力谱系(MLA→NSA→DSA→CSA/HCA)则将KV缓存与长上下文计算压缩一至两个数量级:MLA将每token KV缓存降至传统MHA的约4%,NSA在64k上下文实现最高9.0倍前向加速,DeepSeek-V4将单token推理FLOPs降至前代的27%(Flash版为10%)、KV缓存占用降至10%(Flash版7%)。算法降本直接传导至价格:2025年9月V3.2-Exp发布当日API降价超50%。
核心观点三:国产芯片适配已从“可用”进入“好用”阶段,Day 0适配成为行业范式。DeepSeek-V4发布当日即获寒武纪、华为昇腾Day 0适配,截至2026年4月30日已有8家国产芯片厂商完成适配;华为昇腾超节点全系列支持V4,并有券商研报指出华为芯片参与了V4-Flash的部分训练环节。2026年上半年,七家国产AI芯片公司合计收入约214.6亿元、接近上年同期两倍,寒武纪、摩尔线程、天数智芯等业绩集体兑现。
核心观点四:“终结单点依赖”的准确含义是“脱钩但非封闭”。中国实验室正形成“国产+进口”双轨模式:国产芯片承担推理为主,高端训练仍有进口芯片参与;制约因素集中在先进制程产能(中芯国际7nm级月产能与台积电存在量级差距)、HBM供应(2026年国产AI芯片因HBM短缺集体涨价)与CUDA生态迁移成本三方面。国海证券预计超节点市场2026/2027/2028年分别达889亿/4151亿/11089亿元(2025-2028年CAGR约341%,隐含2025年基期约129亿元),系统级创新正以“以系统补芯片”的方式对冲单卡代差。
二 高端GPU单点依赖:现状、成因与算力经济学
2.1 出口管制演进:从“限性能”到“限生态”再到“政策回摆”
美国对华AI芯片管制经历了四个阶段。第一阶段(2022年10月起):美国商务部工业与安全局(BIS)发布首轮“先进计算”出口管制,A100/H100等高端芯片对华受阻,英伟达推出降规格的A800/H800维持中国市场。第二阶段(2023年10月):管制规则升级,英伟达被迫推出H20、L20、L2等“二次降规”产品,其中H20训练算力约为H100的十分之一。第三阶段(2024年12月-2025年4月):BIS将管制延伸至HBM等先进存储,并宣告H20对华出口需许可证且无限期生效。第四阶段(2025年7月-2026年):政策出现回摆——2025年7月H20以向美国政府上缴15%收入的条件恢复销售;2025年12月特朗普宣布允许H200对华销售、需缴纳25%费用,2026年1月BIS将对华H200出口从“推定拒绝”调整为“逐案审查”。
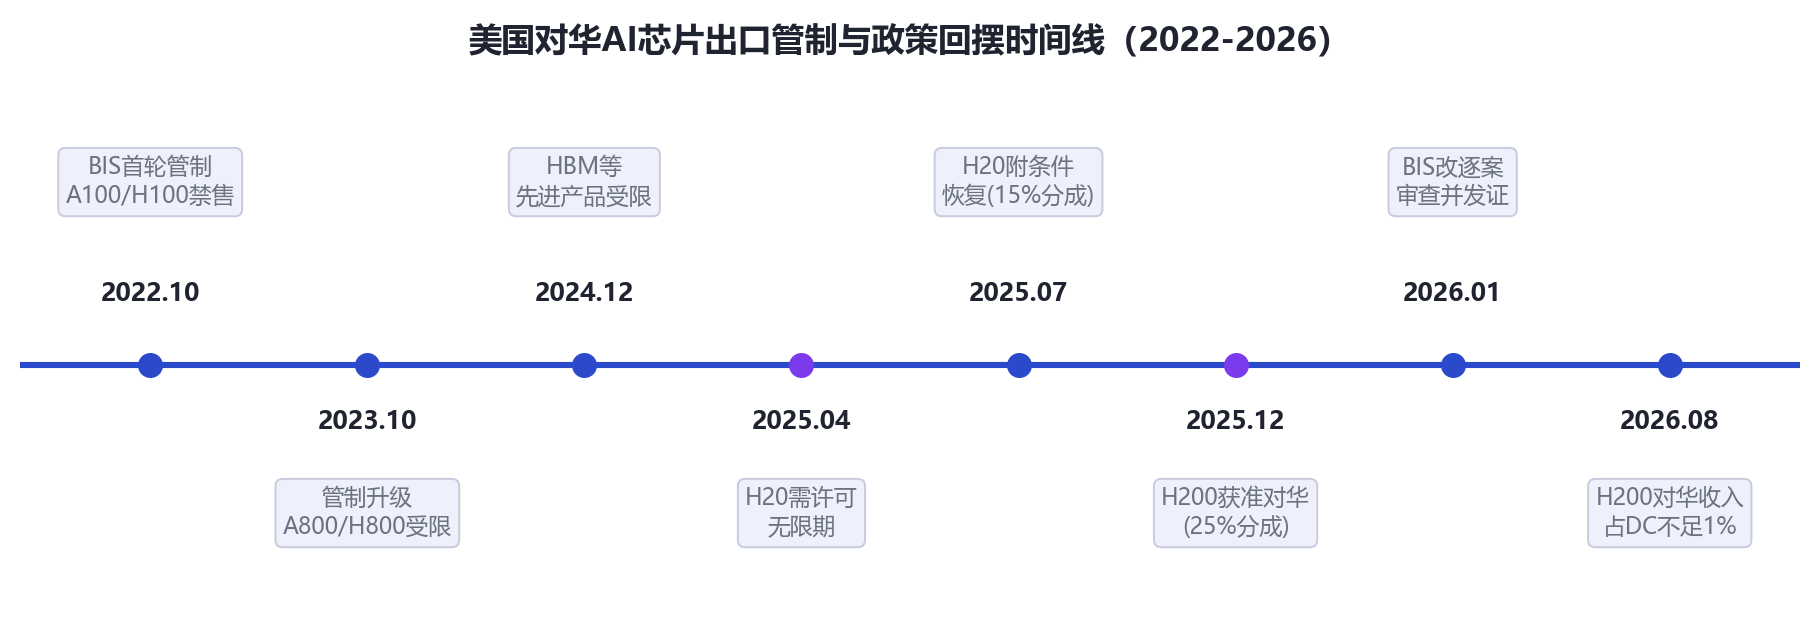
图2-1 美国对华AI芯片出口管制与政策回摆时间线(2022-2026)
值得注意的是政策回摆的商业结果:英伟达2027财年第二季度(FY2027Q2,截至2026年7月)总营收达962亿美元、数据中心收入890亿美元,但按许可证向中国交付的H200收入占数据中心总收入不足1%;公司同时为H200过剩库存计提约4亿美元,并在下一季度指引中继续不假设任何中国数据中心收入。中国市场(含香港)本季度(FY2027Q2)贡献约79亿美元、占总收入8.2%,已从曾经的13.1%(FY2025,约171亿美元)大幅边缘化。这印证了一个结构性事实:出口管制并未换回美国芯片的在华市场,反而将需求让渡给了国产供给。
2.2 市场格局:国产份额首次突破四成
IDC数据显示,2025年中国AI加速卡市场总出货量约400万张。其中国产厂商合计出货约165万张、份额约41%,首次突破四成大关;英伟达出货约220万张、份额约55%;AMD出货约16万张、份额约4%。国产阵营内部,华为以约81.2万颗、约20%的份额居首(约占国产出货一半);阿里平头哥出货约26.5万张居国产第二;百度昆仑芯与寒武纪各出货约11.6万张并列国产第三;海光信息、沐曦股份、天数智芯分别占国产出货的5%、4%、3%。
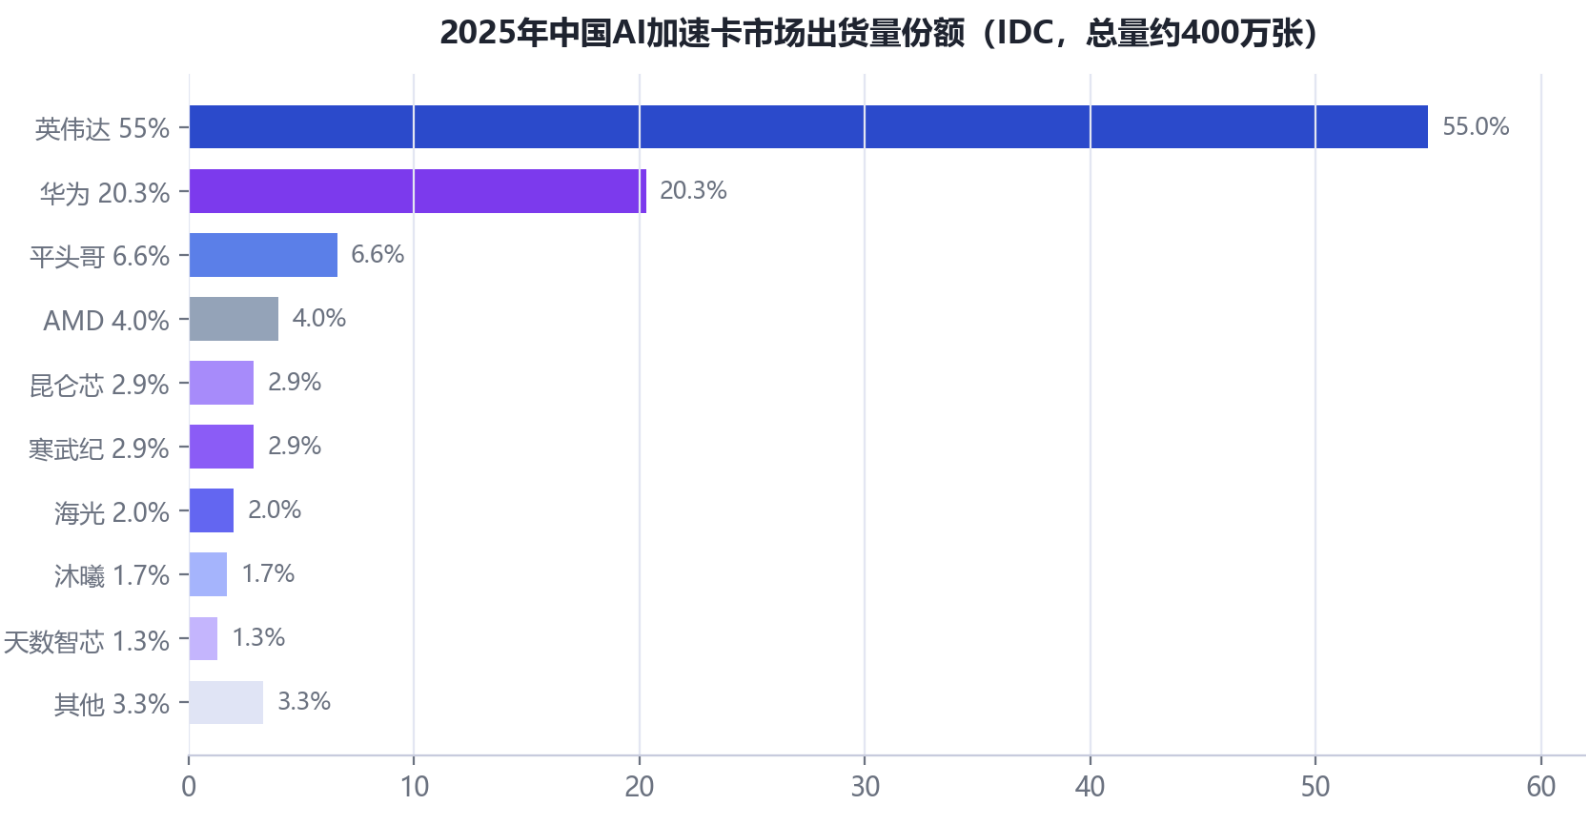
图2-2 2025年中国AI加速卡市场份额
更前瞻的机构预测显示替代进程仍在加速:TrendForce于2026年8月将2026年中国高端AI芯片市场国产份额预测从约50%大幅上调至接近90%,并称这一修正“在八个月内完成”,反映的是结构性而非周期性变化;Bernstein按中国市场收入口径预测英伟达份额将从2025年的约40%降至2026年的约8%,2026年国产AI加速器市场规模约190亿美元、份额79%,2028年达820亿美元、份额93%;高盛预计2026年国产AI加速卡出货份额有望超过50%。IDC季度数据显示,2026年第一季度中国AI芯片市场规模同比高增长(IDC官方口径约+30.9%,媒体另有“超80%”转述口径,出入较大),国产份额首次突破五成(第三方统计口径约52.3%)。作为对照,IDC口径下2024年中国本土AI芯片品牌渗透率仅约30%、出货约82万张——约一年半内(2024年至2026年一季度),国产份额完成了从约三分之一到超半数的跨越。
2.3 单点依赖的三重表现与算力经济学
高端GPU单点依赖本质上不是“要不要买”的问题,而是“成本—供给—生态”三重锁定的复合问题。
其一,供给锁定的不确定性:H20曾承担中国约60%的AI推理工作负载,其供给在2025年经历“禁售—恢复—再禁”的反复,中国监管层面亦引导企业避免将H20用于政府或安全用途、推动采用国产芯片。
其二,成本锁定:以H20为例,其训练算力约为H100的1/10,但凭借大显存配置在部分推理场景效能反而优于H100约20%(SemiAnalysis口径),这种“为合规而设计”的产品形态扭曲了中国用户的采购性价比。其三,生态锁定:CUDA生态构成最深的护城河,国产芯片厂商普遍以“兼容CUDA+自建生态”双轨策略应对(详见第五章)。
从算力经济学视角看,中国AI产业的核心矛盾已经从“能否买到芯片”转向“能否养得起算力”。IDC与浪潮信息预测,2023-2028年中国智能算力规模年复合增长率达46.2%,2026年有望达到约1460.3 EFLOPS;到2027年推理将占智能算力需求的70%以上。截至2026年3月底,全国智能算力总规模已达1882 EFLOPS(FP16),八大国家枢纽节点占比超过80%。(注:IDC/浪潮的1460.3 EFLOPS为2025年初预测值,国家数据局的1882 EFLOPS为截至2026年3月底的已安装实测口径,两者时点与统计范围不同,实际进展已超原预测。)在这一需求曲线下,任何单点供给的波动都会被放大为全行业成本冲击——这正是“降本双轮”成为产业共识的根本动因。
三 算法侧第一轮:稀疏注意力架构创新
3.1 问题根源:注意力机制的平方复杂度与KV缓存经济学
Transformer自注意力机制的 computation 与显存占用随上下文长度呈平方级/线性膨胀:以Llama 3.1-70B(GQA架构)为例,每token KV缓存约320KB,128K上下文单会话即需约40GB显存,100万token则需约320GB——即便英伟达旗舰单卡显存也难以容纳。由于大模型解码是逐token生成,KV缓存的读取频次极高,显存容量与带宽直接决定了按token计费生意收入上限。因此,“压缩KV缓存+稀疏化注意力计算”成为推理降本的第一杠杆。
3.2 技术谱系:从MQA/GQA到MLA、NSA、DSA、CSA/HCA
表3-1 稀疏注意力技术谱系(国产团队主导的迭代路线)
技术 | 提出方/时间 | 核心思路 | 量化效果 |
MQA/GQA | 社区/Meta等 | 多查询头共享/分组共享KV | Llama 3.1-70B将单token缓存从约2.5MB降至320KB |
MLA 多头潜在注意力 | DeepSeek(2024) | 低秩KV联合压缩,映射到低维潜空间 | 每token KV缓存约34.6K元素,为对比基准MHA(860.2K)的约4%(该基准值与V3实际配置不同,第三方实测约1.75%);较GQA基线再降93.3% |
NSA 原生稀疏注意力 | DeepSeek(2025-02) | 压缩/选择/滑窗三分支原生可训练稀疏注意力 | 64k上下文前向加速最高9.0倍、反向6.0倍(vs Triton版FlashAttention-2) |
DSA DeepSeek稀疏注意力 | DeepSeek(2025-09,V3.2-Exp) | 轻量打分器筛选关键token | 支撑API降价超50%:缓存未命中输入0.56→0.28美元/百万tokens |
CSA+HCA 混合注意力 | DeepSeek(2026-04,V4) | CSA每4 token KV合并1条摘要+Top-K选择;HCA每128 token压缩为1条全局摘要 | 单token推理FLOPs降至V3.2的27%(Flash版10%);KV缓存降至10%(Flash版7%) |
这条技术路线有两个关键工程特征。
第一,原生可训练:NSA强调硬件对齐与原生训练支持,避免“训练全注意力、推理再稀疏化”的精度损失,其加速随上下文长度增加而扩大。
第二,与低精度协同:V4.1-Flash以FP4格式存储全局KV缓存(训练阶段即引入),将HBM需求降至V4 Flash的1/4、SSD需求降至1/8,较初代模型累计压缩约437倍。
3.3 降本效果的量化与商业传导
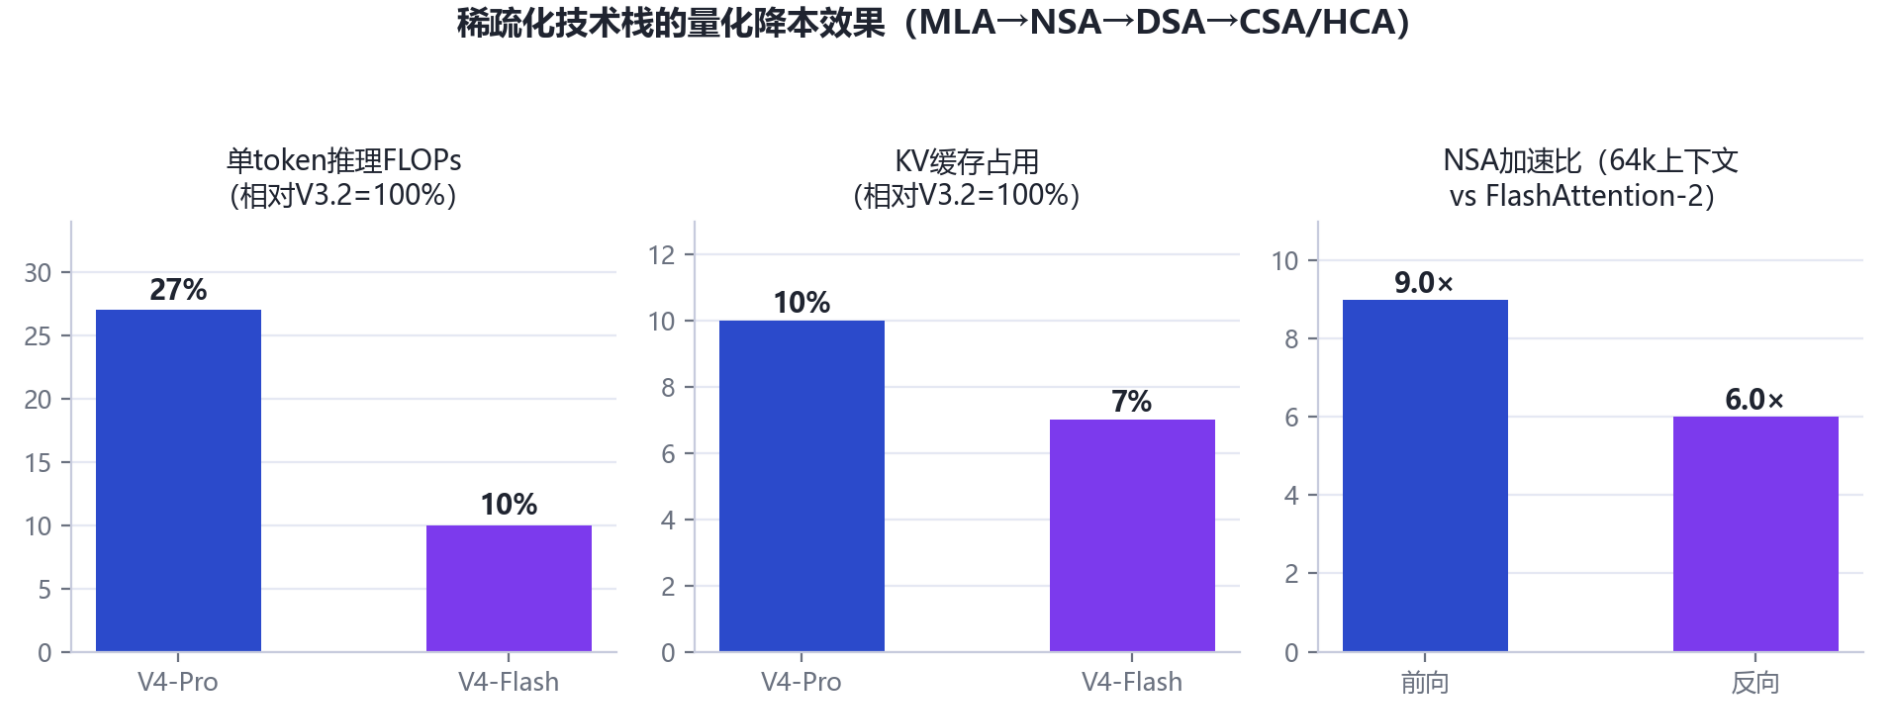
图3-1 稀疏化技术栈的量化降本效果
稀疏化的降本效果已直接传导至API定价。2025年9月29日,DeepSeek发布V3.2-Exp并引入DSA,API价格同步下调超50%:缓存未命中输入价格从0.56美元/百万tokens降至0.28美元,缓存命中输入0.028美元,输出0.42美元。2026年4月24日发布的DeepSeek-V4将1M上下文设为全系标配,凭借CSA+HCA混合注意力实现“百万token普惠”;随后V4.1-Flash将持久化缓存占用进一步压缩,官方称DeepSeek V1的KV缓存是V4.1-Flash的437倍。
这一轮算法降本的意义在于:它降低的是“单位智能”的算力消耗,因而与芯片供给解耦——无论跑在英伟达还是国产芯片上,稀疏化都能同比降低成本。更重要的是,稀疏化对显存带宽与容量的依赖高于对峰值算力的依赖,客观上降低了国产芯片的单卡规格门槛,为软硬协同创造了空间。国内工程实践已经跟进:摩尔线程在S5000上完成DeepSeek-V4全链路适配,其FlashMLA-DSA算子BF16 Tensor算力利用率达50%;智谱GLM-5.3-Flash采用线性+稀疏混合注意力,注意力计算量较GLM-5.3降低3.01倍、KV缓存降低4.44倍。
四 算法侧第二轮:MoE架构演进与成本效益
4.1 MoE的“两本账”:总参数承载知识,激活参数决定账单
MoE(混合专家)将巨型网络拆分为多个“专家”,每个token仅激活其中少数几个,从而把“知识容量”与“计算成本”解耦为两本账。这一架构在2024-2025年成为前沿大模型的既定默认:DeepSeek-V3以671B总参/37B激活实现GPT-4级竞争力;Qwen3系列提供235B-A22B与30B-A3B两种MoE变体(128专家、每token激活8个、全局批次负载均衡);Kimi K2以1T总参/32B激活成为国内首个开源万亿参数MoE模型。
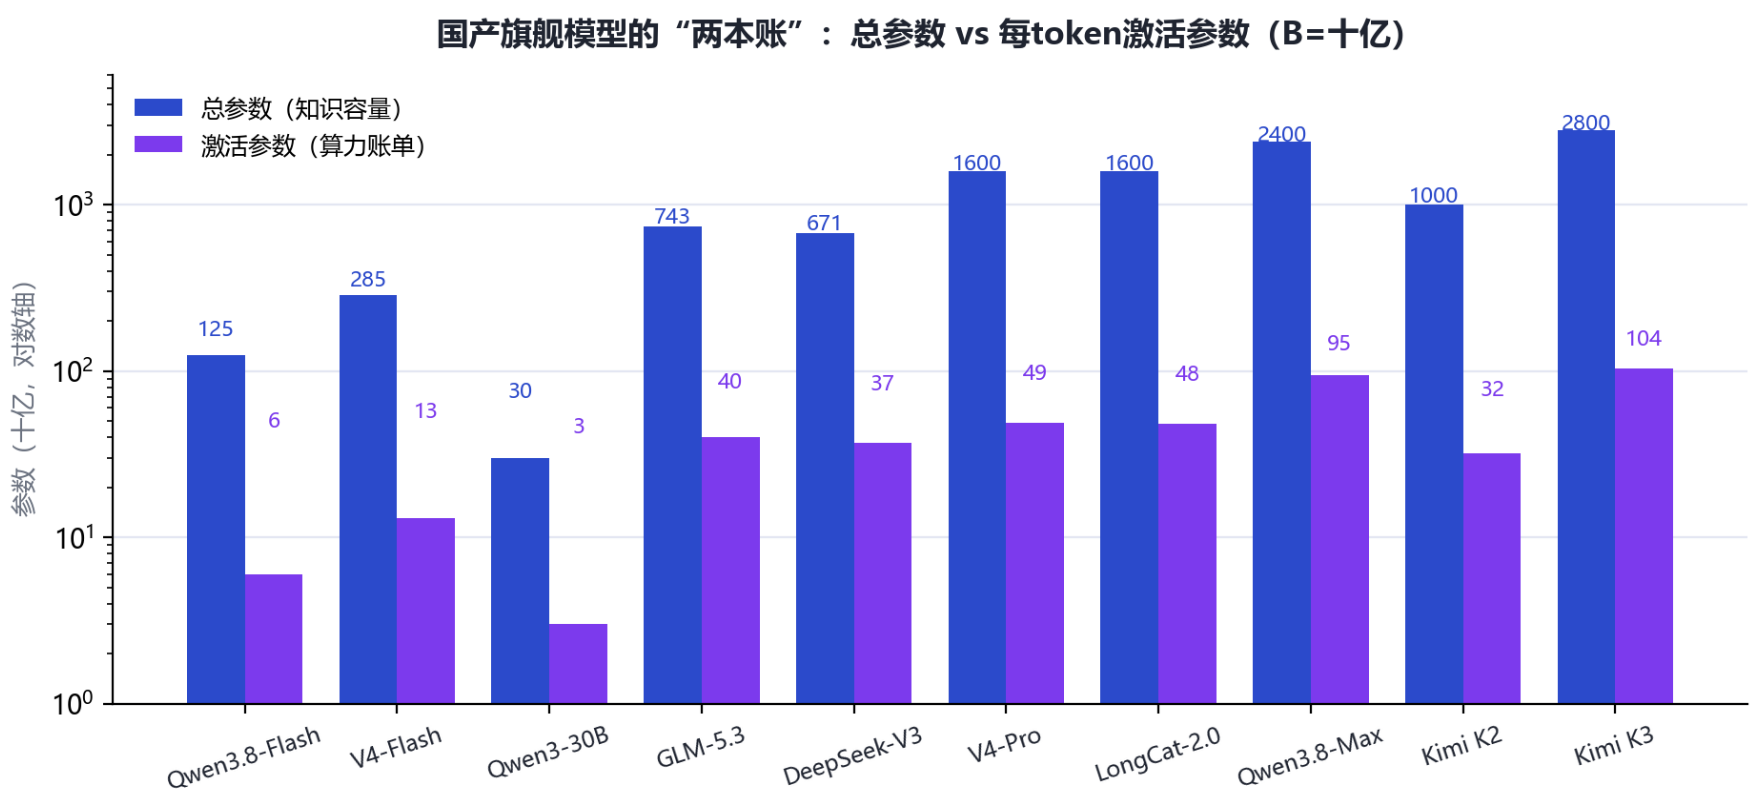
图4-1 国产旗舰模型的“两本账”:总参数 vs 激活参数
4.2 标杆案例:DeepSeek-V3的训练成本革命
DeepSeek-V3是MoE降本的标杆。其采用MLA+DeepSeekMoE架构、首创无辅助损失负载均衡,以FP8精度完成671B参数训练并开源原生FP8权重;完整训练仅消耗278.8万H800 GPU小时(预训练266.4万+上下文扩展11.9万+后训练0.5万),按每GPU小时2美元测算成本约557.6万美元。作为对照,Meta Llama 3.1 405B官方披露的总训练量约3930万H100 GPU小时(与V3的H800 GPU小时口径不同、跨硬件不宜直接相除);就激活参数量而言,V3(37B激活)约为405B稠密模型的1/11。科智咨询测算,DeepSeek同等模型效果的训练成本仅为海外领先模型的约1/10。需要指出的是,557.6万美元仅为正式训练运行成本,不含前期研究与消融实验投入,但其数量级意义——把旗舰模型训练从“亿美元俱乐部”拉入“数百万美元区间”——已经重塑了行业的成本预期。
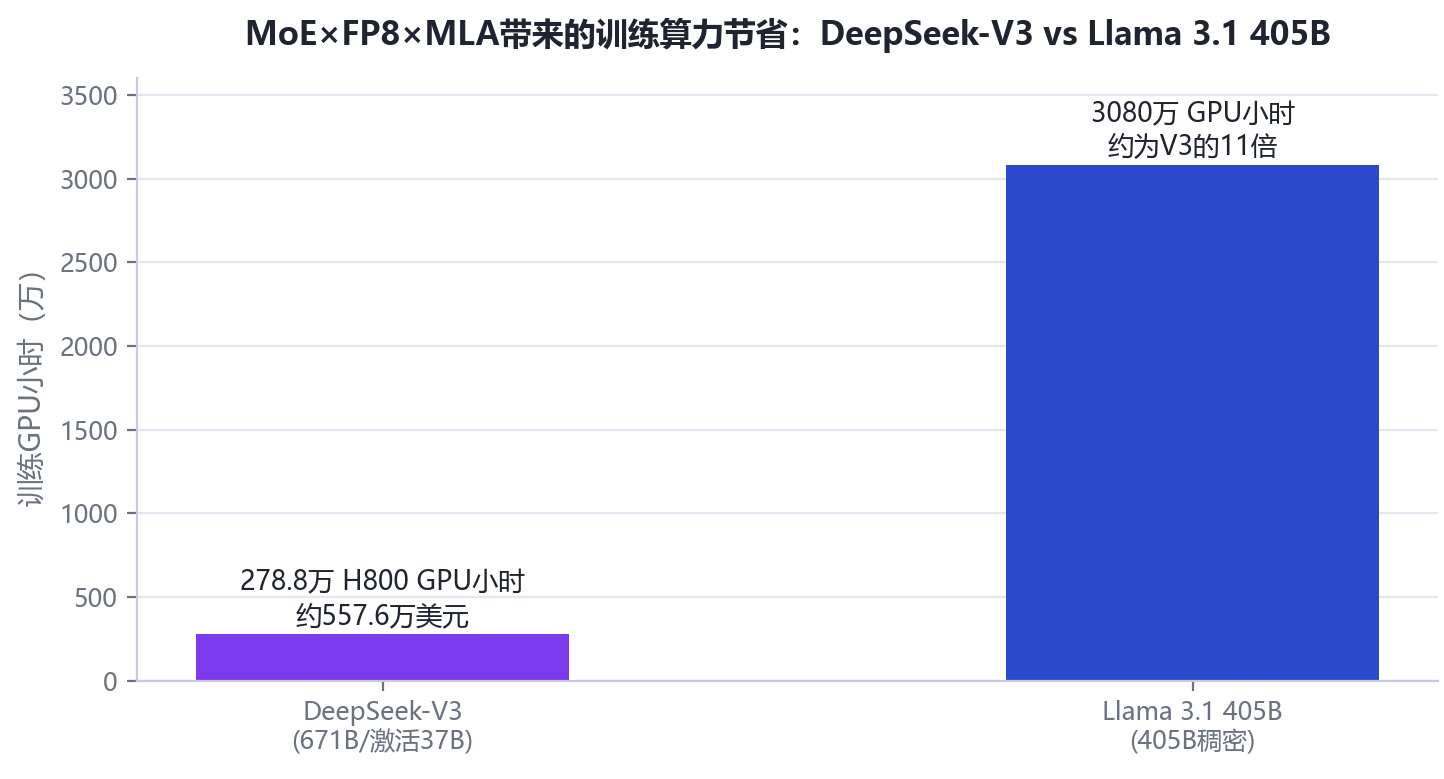
图4-2 DeepSeek-V3 vs Llama 3.1 405B训练算力对比
4.3 国产模型军团:稀疏化与MoE的极致化竞赛
2026年以来,国产模型将“MoE×稀疏注意力×低精度”推向极致。2026年4月24日,DeepSeek发布V4系列:Pro版1.6T总参/49B激活,Flash版284B总参/13B激活,采用CSA+HCA混合注意力、流形约束超连接(mHC)与Muon优化器,1M上下文成为全系标配。7月16日,月之暗面发布Kimi K3(2.8T总参/约104B激活、896个专家每token激活16个),成为全球首个开放3T级权重的模型,官方报告称1M上下文推理速度较K2提升约6.3倍。8月,阿里开源Qwen3.8-Max(2.4T/95B激活、512专家),并于8月26日发布Qwen3.8-Flash(Transformer参数125B仅激活6B,GDN+QSA混合注意力,训练成本较上代骤降近90%,定价每百万tokens输入1元/输出3元,24小时内再降至0.8元/2.7元);同日智谱开源GLM-5.3-Flash(320B/18B)。7月6日,美团开源LongCat-2.0(1.6T总参/平均激活约48B),采用自研LSA稀疏注意力、ScMoE跨层快捷连接与零计算专家机制。
表4-1 国产旗舰MoE模型一览(2024-2026)
模型 | 厂商 | 发布时间 | 总参数 | 激活参数 | 关键特征 |
DeepSeek-V3 | 深度求索 | 2024-12 | 671B | 37B | MLA+MoE、FP8训练、无辅助损失负载均衡 |
Qwen3-235B-A22B | 阿里 | 2025-04 | 235B | 22B | 128专家/激活8个、全局批次负载均衡 |
Kimi K2 | 月之暗面 | 2025-07 | 1T | 32B | 国内首个开源万亿MoE |
DeepSeek-V4-Pro | 深度求索 | 2026-04 | 1.6T | 49B | CSA+HCA、mHC、Muon、1M上下文 |
Kimi K3 | 月之暗面 | 2026-07 | 2.8T | 约104B | 896专家/激活16个、KDA、全球首个3T开放权重 |
LongCat-2.0 | 美团 | 2026-07 | 1.6T | 约48B | LSA稀疏注意力、零计算专家 |
Qwen3.8-Max | 阿里 | 2026-08 | 2.4T | 95B | 512专家选10+1共享、MTP |
GLM-5.3 | 智谱 | 2026-08 | 744B | 40B | 1M上下文 |
Qwen3.8-Flash | 阿里 | 2026-08 | 125B | 6B | GDN+QSA、训练成本降近90% |
GLM-5.3-Flash | 智谱 | 2026-08 | 320B | 18B | 线性+稀疏混合注意力 |
这场竞赛的产业含义有二。其一,推理成本进入“厘时代”:随着激活参数降至个位数十亿、KV缓存压缩至前代十分之一以下,旗舰能力的单位推理成本呈数量级下降,智能正在从“稀缺”走向“普惠”。其二,模型架构反向定义芯片需求:稀疏MoE的高频All-to-All通信、动态路由对负载均衡的要求、低精度(FP8/FP4)算力的偏好,都在重新划定国产芯片的优先优化方向——这正是第六章“双轮协同”的技术接口。
五 国产芯片供给侧全景与适配生态
5.1 竞争格局:一超多强与新势力,业绩进入兑现期
中国云端AI芯片市场已形成“一超(华为昇腾)、多强(寒武纪、平头哥、昆仑芯、海光信息)、新势力(摩尔线程、沐曦、壁仞、天数智芯、燧原等)”的梯队。2025年资本化明显提速:摩尔线程于2025年12月5日登陆科创板(发行价114.28元/股、募资80亿元,成为“国产GPU第一股”),沐曦紧随其后,2026年1月壁仞科技、天数智芯相继在港交所上市,2026年9月燧原科技申购(拟募资60亿元)。从财务看,行业已跨过“样片—测试—批量交付”门槛:2026年上半年七家公司合计收入约214.6亿元、接近上年同期两倍,其中寒武纪59.96亿元(+108.13%)、归母净利23.11亿元(+122.61%),摩尔线程17.36亿元(+147.42%、已超其2025年全年15.06亿元),天数智芯扭亏(+191.6%),燧原+279%、壁仞在低基数上增长1997.6%。
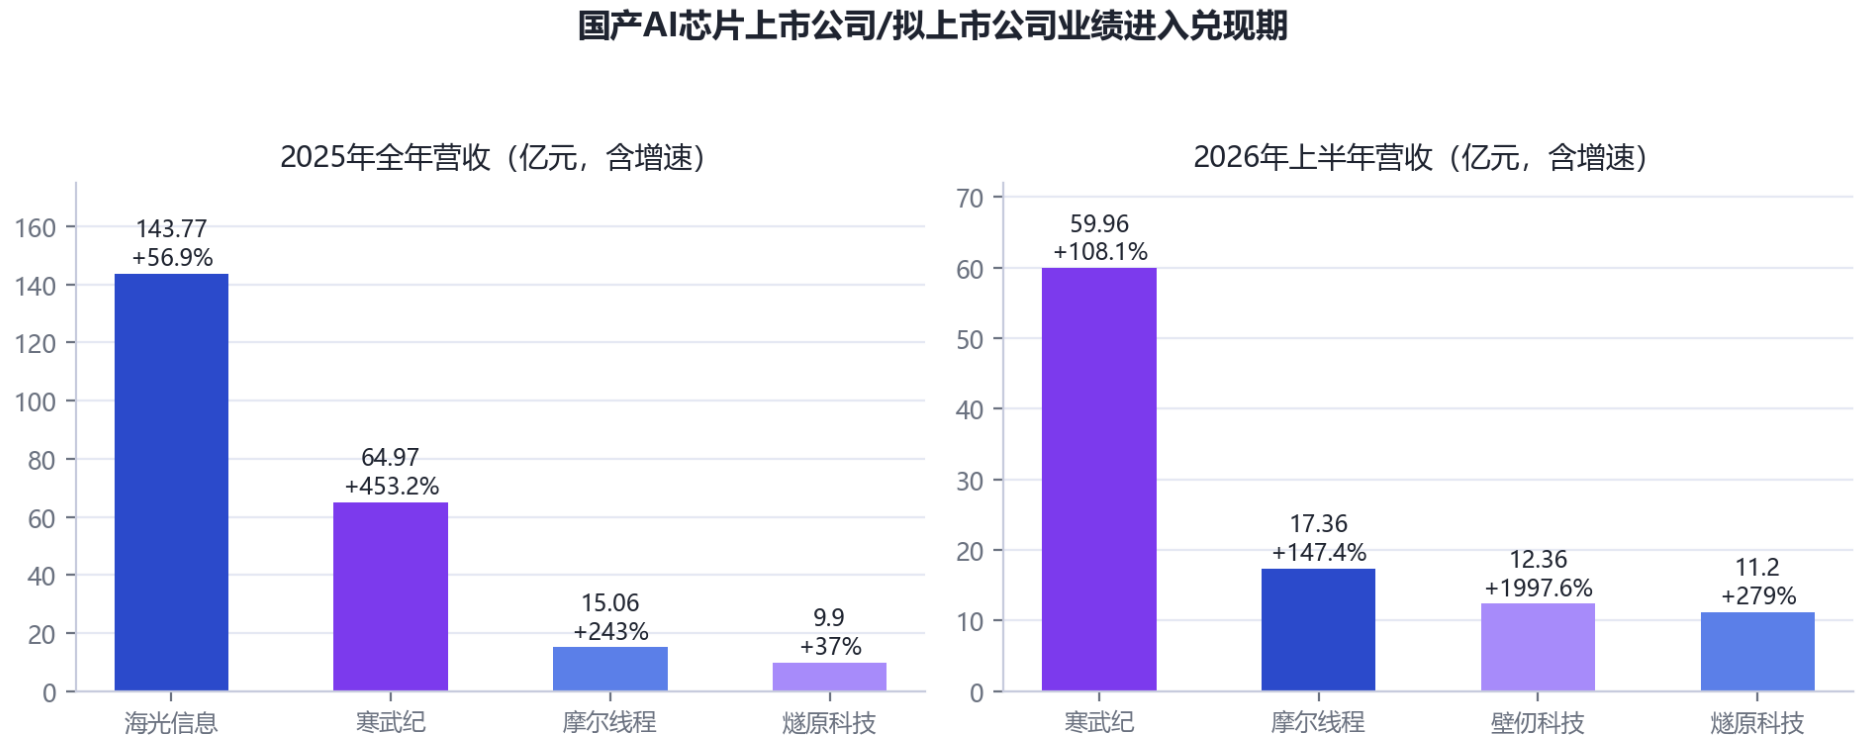
图5-1 国产AI芯片公司业绩进入兑现期(各公司年报/半年报)
技术路线上,行业呈现三大阵营:GPGPU阵营(摩尔线程、沐曦、壁仞、天数智芯)兼容CUDA生态、迁移成本低;自研架构阵营(寒武纪、燧原)构建专用架构与软件栈;CPU+DCU双线(海光信息)依托“类CUDA”生态实现业务迁移。2025年年报与2026年一季报显示,海光信息2025年营收143.77亿元(+56.92%)、净利25.45亿元(+31.79%),2026年一季度营收40.34亿元(+68.06%);寒武纪2025年营收64.97亿元(+453.21%)、上市以来首次年度盈利。
5.2 华为昇腾:以路线图与超节点实施“系统级补偿”
华为是国产阵营的“一超”。2025年9月18日,华为轮值董事长徐直军首次公开三年芯片路线图:昇腾950PR(2026年一季度,搭载自研HiBL 1.0 HBM)、950DT(2026年四季度,搭载HiZQ 2.0)、960(2027年四季度,支持HiF4自研4比特格式)、970(2028年四季度),保持“每年一代”节奏。2026年3月,搭载昇腾950PR的Atlas 350加速卡已发布亮相。当前主力昇腾910C的FP16稠密算力约780-800 TFLOPS(不同口径:券商测算780、路线图表800、SemiAnalysis实测口径752)、内存带宽3.2TB/s,综合性能接近H100的80%;上一代910B(FP16稠密320 TFLOPS)可对标A100(312 TFLOPS)。
华为应对单卡代差的核心打法是“以系统补芯片”。CloudMatrix 384超节点基于384颗910C构建,BF16稠密算力达300 PFLOPS、为英伟达GB200 NVL72的1.7倍,总内存容量与内存带宽分别为其3.6倍和2.1倍;SemiAnalysis评价CM384在多项关键指标上超越GB200 NVL72、领先英伟达和AMD产品一代,连黄仁勋也公开承认其部分性能超过英伟达产品。下一代Atlas 950 SuperPoD最大可扩展8192颗NPU(单柜64颗),华为称其卡规模为英伟达NVL144的56.8倍、总算力6.7倍、内存容量15倍(1152TB)、互联带宽62倍。
5.3 软件栈:CANN开源开放与“类CUDA”迁移路径
软件生态是国产芯片从“可用”到“好用”的分水岭。华为于2025年8月宣布CANN全面开源开放;2026年9月社区版已迭代至9.2.0-beta.2,原生支持DeepSeek-V4、Qwen3.6、Kimi-K2.6、GLM5.2等前沿模型,其MLA融合算子(MLAPO,2025年5月)针对DeepSeek的MLA架构实现推理效率倍增。寒武纪开放NeuWare软件栈与vLLM-MLU源码,以Torch-MLU-Ops融合算子库和BangC语言释放硬件潜力;海光DTK+DAS集成超2000个算子、支持100余个主流框架组件;摩尔线程MUSA架构已深度兼容CUDA生态,MUSIFY工具支持CUDA代码快速迁移,生态汇聚超80万名开发者。昆仑芯则在2025年中国移动集采“类CUDA生态”标段中以三项标包份额第一斩获十亿级订单。
5.4 硬约束:先进制程产能与HBM供应
国产算力的天花板仍在制造与存储两端。制造端,据爱集微援引TrendForce的测算,国内7nm级量产代工实质上仅中芯国际一家,其月产能不足2万片、远低于台积电同制程约15万片;按2026年底目标月产能7万片折算,全年可产出的AI芯片约260万颗,而同期国内需求约420万颗——每两颗需求中约有一颗无法满足;产能分配上华为约占43%、寒武纪占9%-11%。存储端更为紧张:2024年12月美国收紧先进HBM对华出口后,中国厂商转向灰色市场渠道采购、价格达正常渠道数倍;路透社2026年9月报道,华为昇腾950DT加速卡报价已上调至25万元以上(较两个月前上涨20%-50%),950PR由年初约6万元升至8万元以上,910C由约9万元升至11万元以上,寒武纪下一代思元690报价亦上调20%-30%。这构成本报告结论部分情景分析的关键变量:国产替代的“成本优势”部分来自规模与系统工程,部分依赖HBM供给的松紧。
六 双轮协同:架构创新×国产芯片的乘数效应
6.1 Day 0适配成为行业范式
“算法双轮”与“芯片双轮”的交汇点,是大模型与国产芯片的深度耦合。2026年4月24日DeepSeek-V4发布当日,寒武纪、华为昇腾即完成Day 0适配并开源适配代码;截至2026年4月30日,寒武纪、华为昇腾、海光信息、摩尔线程、沐曦股份、百度昆仑芯、阿里平头哥(真武)、天数智芯共8家国产芯片厂商完成适配(部分统计口径另含清微智能共9家;“曦望”未见Day 0适配证据)。华为昇腾超节点全系列产品支持V4,昇腾950通过融合kernel与多流并行技术实现高吞吐、低时延部署,昇腾A3超节点同步提供训练参考实现;万联证券研报进一步指出,华为芯片参与了V4-Flash的部分训练环节,标志着国产算力从推理部署向训练链条渗透。
这一范式正在全行业复制:摩尔线程对DeepSeek-V4、美团LongCat-2.0(万亿参数)等前沿模型实现“发布即适配”;沐曦自2025年12月以来完成33个主流模型Day 0适配,天数智芯累计适配模型超500个;燧原在庆阳、无锡、成都等地智算中心完成DeepSeek全量模型的数万卡部署;智谱则首次在大规模线上流量中采用国产芯片集群提供服务。
6.2 系统级协同:稀疏化×超节点的互补
稀疏注意力/MoE与超节点构成“降维—补维”的互补关系:算法侧稀疏化削减了单卡的计算与访存需求,系统侧超节点则以高带宽、低时延的Scale-up域解决MoE高频All-to-All通信瓶颈——传统集群中MoE训练的集群算力利用率(MFU)往往不足60%,超节点将强耦合通信时延从微秒级压缩至百纳秒级。国海证券测算,国产超节点市场2026/2027/2028年将分别达889亿/4151亿/11089亿元(2025-2028年CAGR约341%),在国产AI芯片出货中的渗透率从2026年约15%提升至2028年约55%;华泰证券的保守口径为2028年约3414亿元。产业侧,曙光、阿里、百度等厂商亦密集推出单柜百卡级超节点系统,华为Atlas 950单柜可部署64颗芯片。2026年7月,粤港澳大湾区首个“国芯训国模”万卡智算集群在韶关上线,部署30个昇腾910C超节点、建成9000P(FP16)资源池、总投资约55亿元。
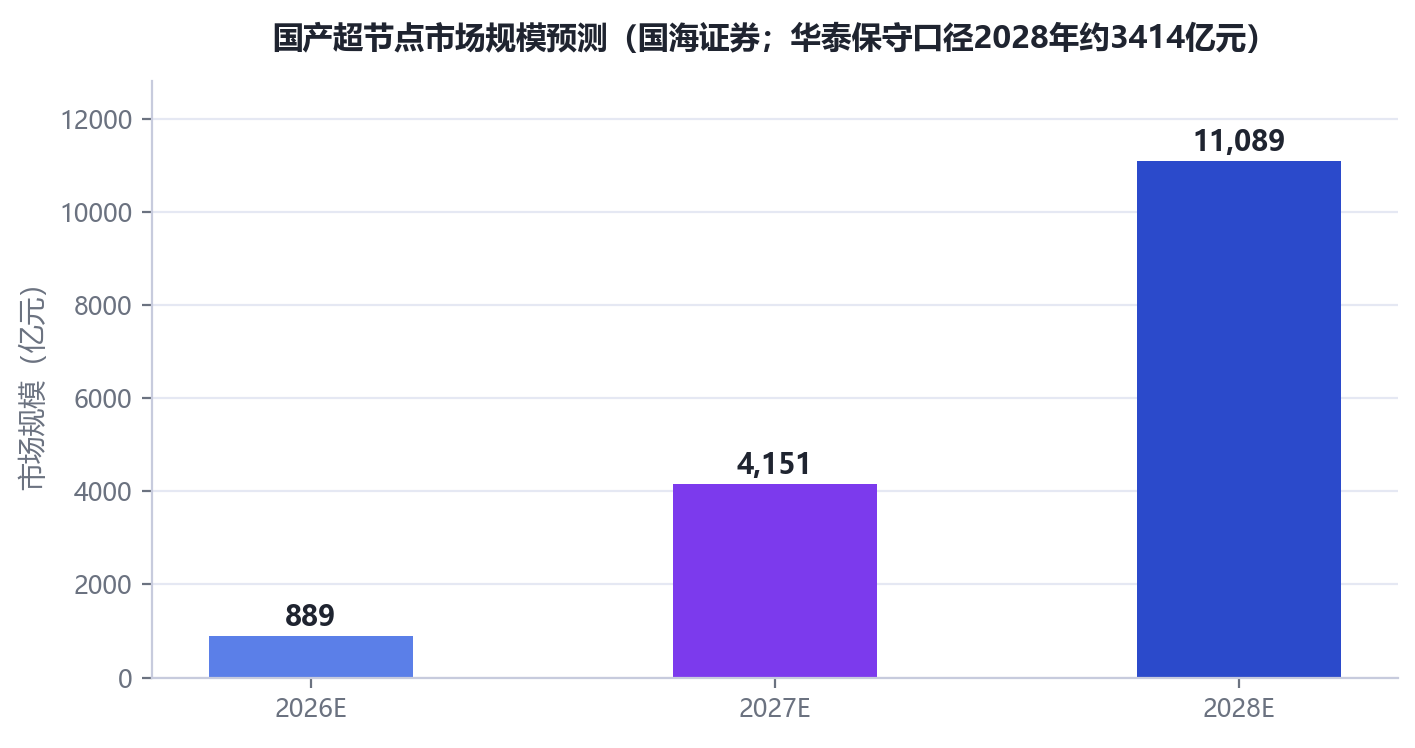
图6-1 国产超节点市场规模预测(国海证券测算)
6.3 训练侧渗透:从推理替代到“国芯训国模”
训练侧是国产替代的深水区。行业观察显示,中国实验室普遍采用“国产+进口”双轨:国产芯片承担AI推理任务,训练阶段仍主要依赖英伟达芯片。典型案例是美团以显存64GB的昇腾910B(小于H800的80GB)完成大模型预训练,科大讯飞的国产化亦从910B起步。而DeepSeek-V4的落地正在改变这一格局:若华为芯片参与V4-Flash训练环节的研报表述得到进一步证实,叠加韶关“国芯训国模”集群、华为昇腾二次训练解决方案的推广,训练侧国产替代的节奏存在超预期空间——券商普遍将其视为2026-2027年最重要的观察变量。
表6-1 产业链关键环节与代表玩家
环节 | 代表企业/主体 | 关键事实 |
AI加速芯片 | 华为昇腾 | 2025年出货约81.2万颗、份额约20%居中国市场第二;CM384/Atlas 950超节点系统级领先 |
AI加速芯片 | 寒武纪 | 2025年出货约11.6万张;2025年营收64.97亿元、首次年度盈利 |
AI加速芯片 | 海光信息 | 2025年营收143.77亿元、净利25.45亿元;DCU类CUDA生态 |
AI加速芯片 | 摩尔线程 | 2025-12科创板上市、募资80亿元;MUSA兼容CUDA、超80万开发者 |
大厂自研 | 平头哥/昆仑芯 | 平头哥2025年出货约26.5万张;PPU用于千问训推、服务400多家客户;昆仑芯点亮3.2万卡集群 |
大模型 | 深度求索/阿里/智谱/月之暗面/美团 | V4/千问3.8/GLM-5.3/K3/LongCat-2.0构成全球最大开源MoE集群 |
软件栈 | CANN/NeuWare/DTK/MUSA | CANN全面开源并适配前沿模型 |
系统/集群 | 华为/曙光/韶关集群 | 超节点2028年市场预计超万亿元;韶关国芯训国模9000P |
七 结论:能否终结高端GPU单点依赖——判断、情景与风险
7.1 总体判断:“单点依赖”已被结构性稀释,推理侧实质突破
综合全文证据链,本报告的结论是:
(1)“终结”在推理侧已接近事实成立——2025年国产加速卡份额41%、2026年一季度突破五成,叠加TrendForce对2026年高端市场国产份额接近90%的预测,中国AI推理的算力底盘已可主要由国产供给承担;DeepSeek V3.2/V4的连续降价(V3.2发布当日API降价超50%、缓存命中输入价格低至0.028美元/百万tokens)证明国产模型+国产芯片组合已具备全球成本竞争力。
(2)训练侧从“不可替代”转为“快速跟进”:MoE+稀疏化将训练成本压缩一个数量级(V3仅557.6万美元),客观上降低了训练对顶尖单卡性能的敏感度,昇腾超节点+国产模型训练的示范效应正在形成。
(3)英伟达自身行为印证了这一趋势:其对华数据中心收入指引持续为零、H200对华销售“象征意义大于实际收入”,并连续两年在年报中将华为列为竞争对手。
7.2 三情景推演(2026-2028)
表7-1 高端GPU依赖演变的三情景推演
情景 | 关键假设 | 演绎路径 | 本报告倾向 |
加速替代(乐观) | 中芯产能如期扩至7万片/月;HBM国产化(HiBL/HiZQ及长鑫等)放量;国产模型持续开源牵引 | 推理侧国产份额稳固在五成以上并向高端训练渗透;2027年超节点成为主流形态;Bernstein口径2028年国产化率93% | 概率中等偏高 |
双轨均衡(基准) | H200/H20类产品维持“象征性供给”;国产供给受产能约束缓慢爬坡 | 推理国产、训练混合的双轨延续;国产份额随产能线性提升,价格因HBM紧张维持高位 | 概率最高 |
反复扰动(悲观) | 管制再度收紧至HBM/设备层面;产能与存储瓶颈超预期 | 国产芯片交付受限、涨价传导至模型服务价格;替代进程延后但不逆转(TrendForce称当前变化为结构性) | 概率较低 |
7.3 市场空间:万亿元级国产替代主战场
市场空间层面,弗若斯特沙利文预测中国AI计算加速芯片市场规模将从2024年的1425亿元增至2029年的约1.34万亿元(2025-2029年CAGR 53.7%,以2025年约2398亿元为基期),GPU份额由69.9%升至77.3%;亿欧智库口径为2026年约2500亿元、2029年约1.34万亿元。需求侧,IDC与浪潮预计2026年中国智能算力规模约1460.3 EFLOPS、2027年推理占比超70%;中商产业研究院预计中国AI服务器市场2026年达3500亿元。全球坐标下,IDC预计2026年全球AI基础设施支出将上调至4970亿美元,其中中国一季度支出78亿美元(+9.3%);灼识咨询预计全球AI加速卡市场将从2024年超1000亿美元增至2028年超5000亿美元。中国是全球AI算力增长最快的单一市场,这为国产供给提供了足够的腹地。
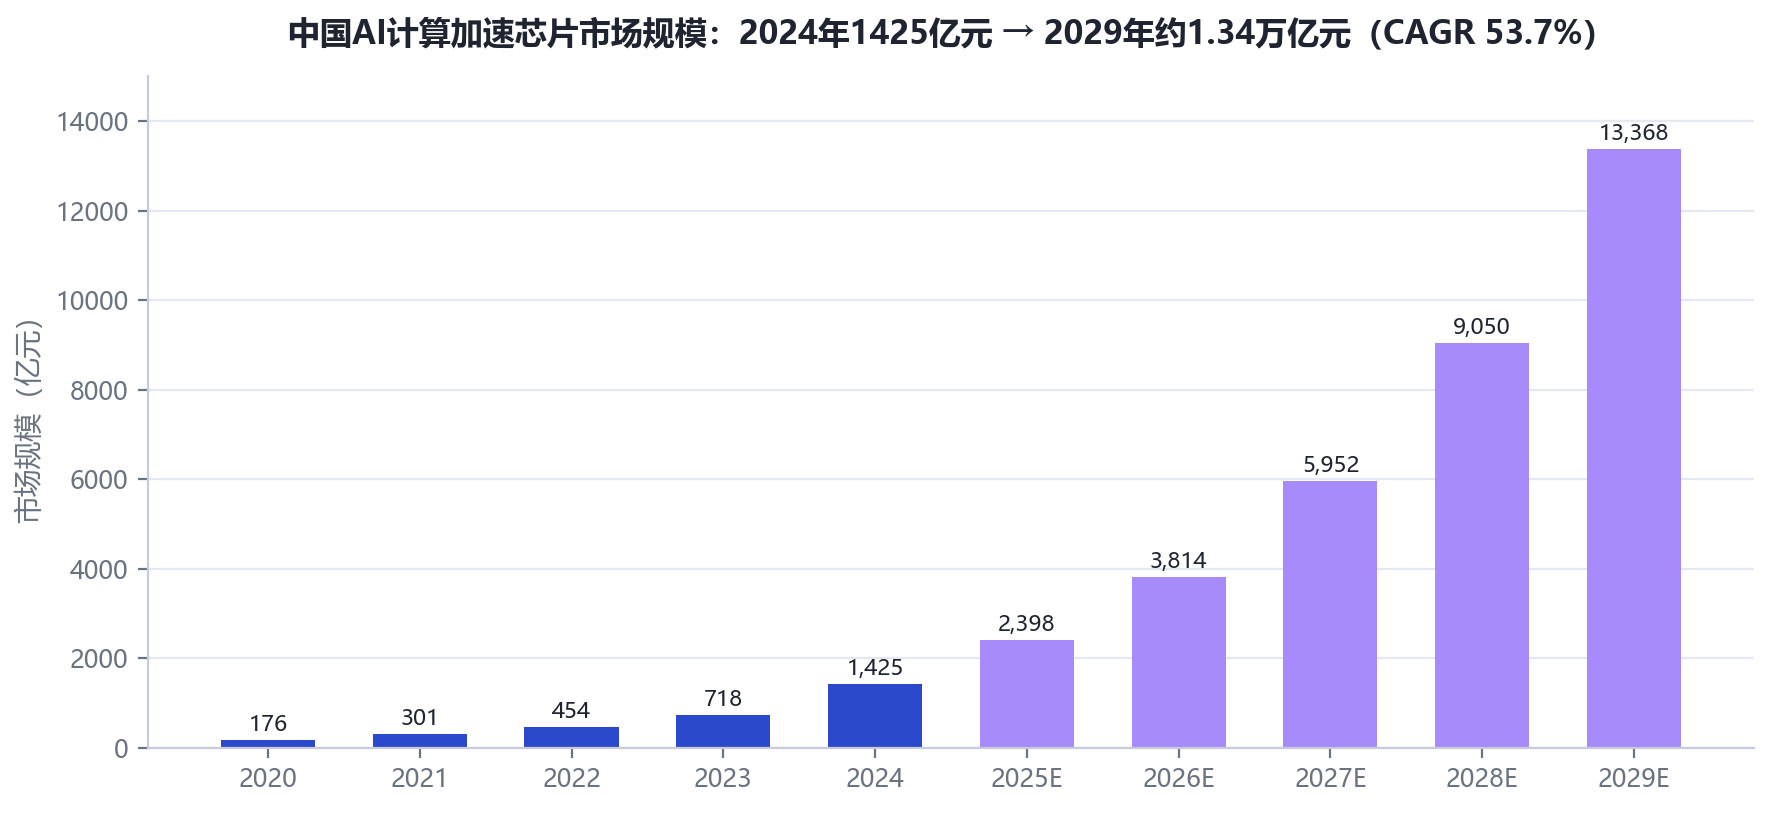
图7-1 中国AI计算加速芯片市场规模预测(弗若斯特沙利文)
7.4 风险提示
· 制造与存储瓶颈:中芯国际7nm级产能与需求间存在约四成缺口,HBM短缺已导致国产芯片集体涨价20%-50%,若延续将侵蚀国产方案的性价比优势;
· 生态迁移成本:CUDA生态存量深厚,国产软件栈(CANN/MUSA/DTK/NeuWare)虽快速迭代,但长尾算子覆盖、框架兼容与人才储备仍需时间沉淀;
· 政策反复风险:美国出口管制存在再度收紧的可能(历史上H20即经历“放行—禁售—附条件放行”的反复),国产化率的提升节奏可能被打断;
· 技术路线风险:稀疏化/MoE的收益依赖模型架构持续演进,若海外团队转向全新架构(如线性注意力大规模替代、新范式出现),现有国产芯片的优化积累可能部分失效;
结语:算力自主化没有“毕其功于一役”的奇袭路径,但有可复利的复利路径——算法侧每压缩一个数量级的成本,国产芯片的单卡压力就小一分;国产芯片每完成一次Day 0适配,算法创新落地的摩擦就少一分。双轮互锁之下,高端GPU的“单点依赖”正在退化为“多点选择”中的一个选项。这正是2026年中国AI算力产业最重要的结构性变化。