桌面级AI计算机NVIDIA DGX Spark为本地AI图像与视频创作、AI编程、个人与团队AI Agent,以及企业私有知识库与文档问答提供算力支持。如何让模型与数据更快就绪、应用更快响应,让桌面算力创造更多实际价值?
近日,苏州紫山龙霖信息科技有限公司(简称“紫山龙霖”,国芯科技参股公司)基于自主研发的GLFS全局数据操作系统(简称“GLFS”), 在NVIDIA DGX Spark平台上进行了大模型加载与KV Cache推理加速测试。
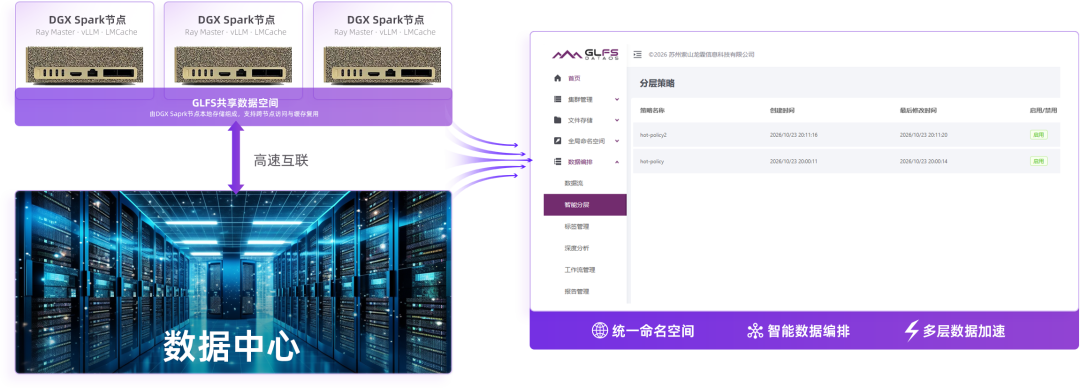
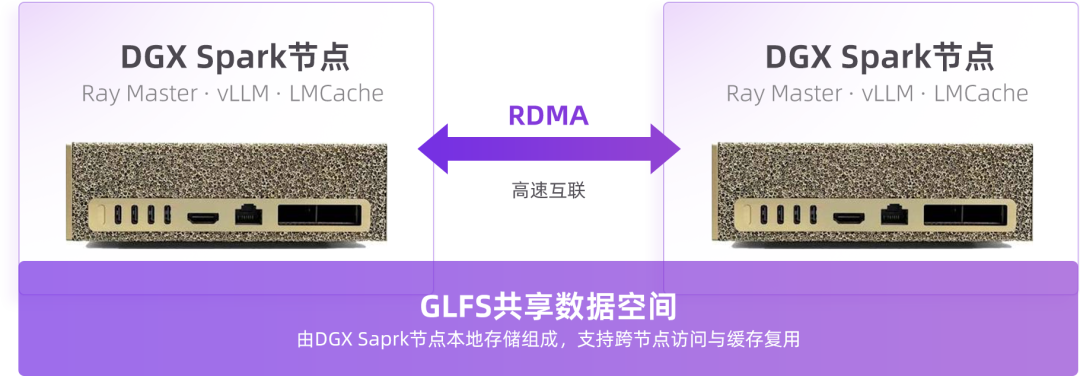
本次测试采用2台NVIDIA DGX Spark,通过单条200Gb/s RoCEv2 RDMA链路互联,同时承载节点间计算通信与存储数据传输。两节点分别部署GLFS,将各自的本地存储整合为统一共享数据空间。
核心测试成果:加载更快、重算更少、协同更高效
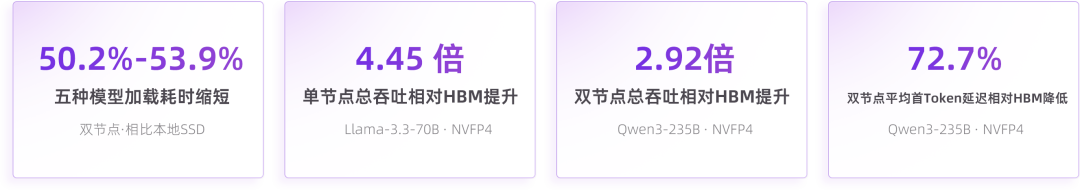
这些结果表明,桌面级AI平台的性能优化不仅取决于计算能力,更取决于数据能否快速到达算力,以及已经完成的计算能否被高效复用。
模型加载减半:把等待时间,还给开发迭代
对于桌面级AI开发者而言,模型切换、推理服务启动和实验迭代都需要频繁加载模型权重。模型参数越大,加载的数据量越多,等待时间也可能越长。
在双节点DGX Spark、vLLM Eager模式下,五种模型的加载耗时较本地SSD缩短50.2%~53.9%。其中,Qwen3-235B-A22B-NVFP4从137.2秒缩短至63.3 秒,每次加载减少约74 秒。
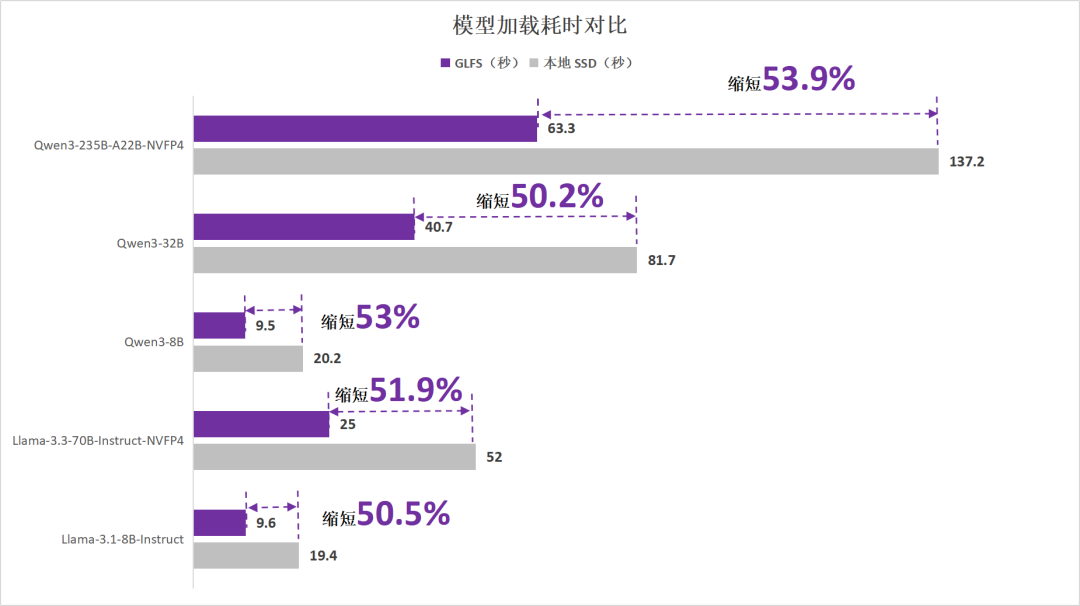
五种模型本地SSD与GLFS加载时间对比图
模型加载时间缩短,意味着开发者能够更快完成模型切换、服务启动和实验验证,让更多时间用于实际AI开发,而不是等待数据加载。
KV Cache复用:减少重复计算,提升推理效率
长文档问答、RAG知识库与多轮对话,经常需要反复处理相同上下文。当缓存因容量不足被淘汰,后续请求便可能重新计算历史内容,增加等待和算力开销。
紫山龙霖通过GLFS与vLLM、LMCache协同,将可复用的KV Cache保存到存储层。后续请求命中相同前缀时,取回已有缓存,减少Prefill(预填充)阶段的重复计算。
单节点实测结果如下:
在Llama-3.3-70B:Token 吞吐达到5,156 Tokens/s,相比HBM基线提升约4.45倍。
Qwen3-8B:Token 吞吐达到6,354 Tokens/s,相比HBM 基线提升约3.06倍。
Qwen3-32B:Token 吞吐达到1,313 Tokens/s,相比HBM 基线提升约2.16倍。
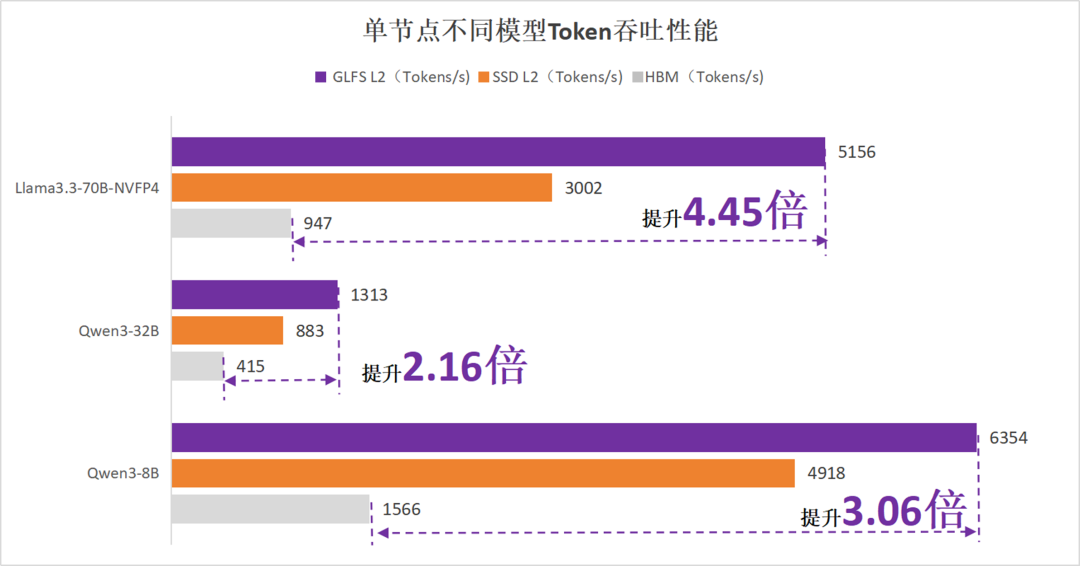
单节点下,GLFS在三种模型下的Token吞吐性能
GLFS的价值不仅是扩展KV Cache存储空间,更是配合推理框架高效复用已计算的上下文,将数据访问效率转化为实际Token产出效率。
双节点共享:让235B大模型推理更高效
当桌面级AI从单机向双机扩展时,模型推理不仅需要计算资源协同,还需要不同节点能够访问共享的上下文缓存。
GLFS通过统一数据空间与高速RDMA网络,将不同DGX Spark节点的存储资源组织起来,为跨节点KV Cache访问提供共享数据基础。
本次测试采用两台DGX Spark,运行Qwen3-235B-A22B-NVFP4模型,测试结果如下:
Token总吞吐:由HBM的1,172 Tokens/s达到4,591 Tokens/s,提升约2.92倍。
平均首Token延迟:由HBM的4.47秒降到1.22秒,降低约72.7%。
P90首Token延迟:由HBM的4.79秒降到1.56秒,降低约67.4%。
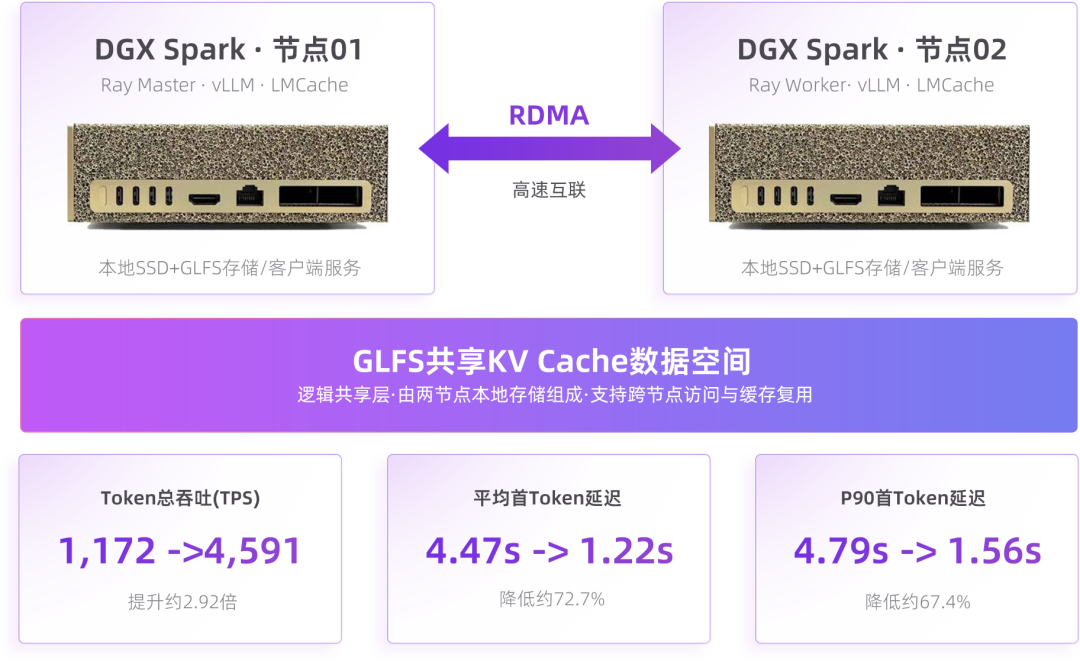
这意味着在相同双节点计算资源下,通过GLFS实现跨节点KV Cache共享与复用,能够显著提高长上下文重复访问场景下的推理效率。
对于企业私有知识库、长文档分析和多轮交互式Agent应用,这种能力有助于减少重复计算、缩短等待时间,并提高现有算力资源的有效产出。
打通桌面与数据中心,加速数据访问
此次测试验证了GLFS直接部署在NVIDIA DGX Spark节点上,对模型加载与推理KV Cache的加速能力。在此基础上,GLFS可通过全局命名空间,将数据中心、云端与DGX Spark本地的数据纳入统一视图,支持数据在文件访问路径不变的情况下按需流动,并利用本地NVMe缓存加速访问,让桌面算力高效使用企业级数据资源。
GLFS全局数据编排通过全局元数据索引、标签管理与变更数据捕获(CDC)机制,持续感知数据变化,并根据访问热度、任务优先级、生命周期及安全策略,自动执行数据分类、索引、预热、分层与归档,让AI任务所需的数据提前就绪、就近可用。
让每一份算力创造更多AI价值
桌面级AI的价值,不仅在于能够运行多大的模型,更在于能否让模型更快启动、让推理更快响应、让已经完成的计算得到充分复用。
本次DGX Spark测试表明,紫山龙霖GLFS通过高性能数据访问、KV Cache外部卸载与跨节点共享,为提升桌面级AI推理效率提供了新的路径。
未来,紫山龙霖将持续深化GLFS与NVIDIA AI计算生态及主流推理框架的适配,布局GalaxBox等桌面级数据加速产品,让数据更快到达算力,让做过的计算少白费,让同样的算力创造更大的AI价值。