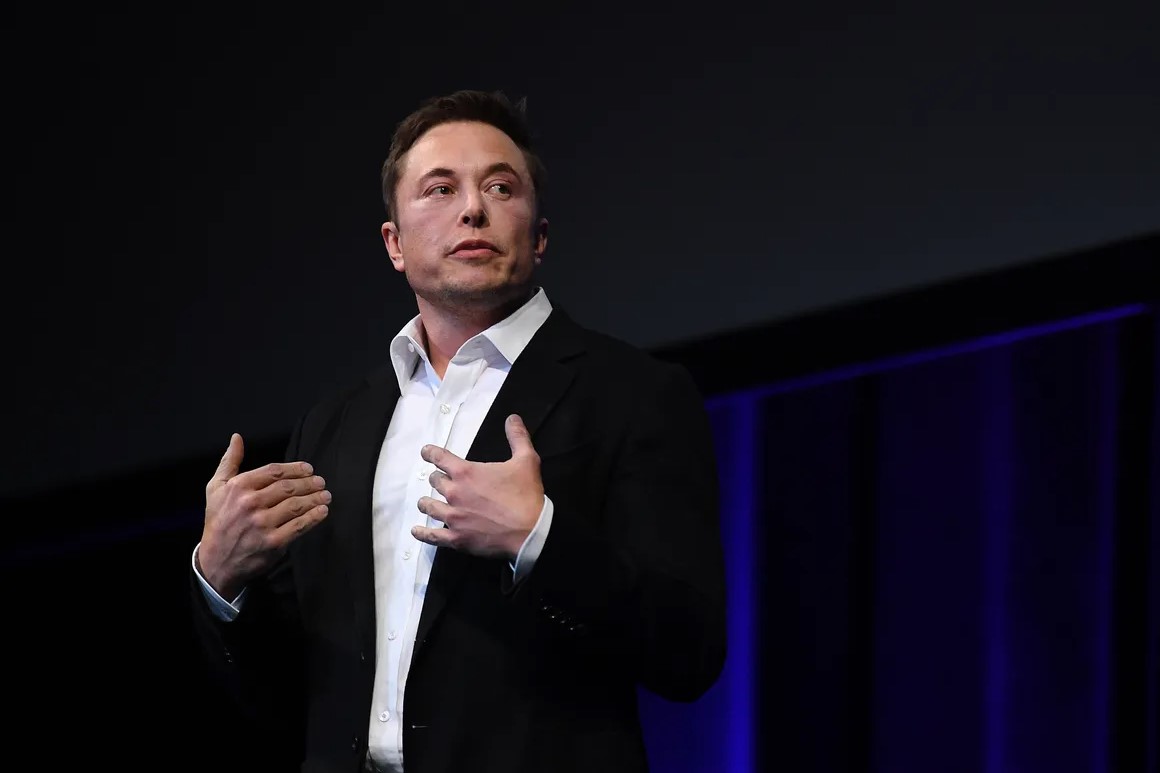
11月12日,百度世界2026大会开幕。在开幕式主论坛上,百度创始人李彦宏一次发布两款文心应用模型——文心闪电深度思考模型与文心一镜微表情大模型,两款模型均已同步上线百度智能云千帆平台,面向企业客户及合作伙伴开放API服务。与以往“旗舰基础模型唱主角”的发布会节奏不同,这一次站在C位的是直接面向业务场景的应用模型。对于正在评估AI投入方向的企业决策者而言,这场发布会传递的信号值得细读。
“两条路径”论:向上突破与向实扎根的战略分工
李彦宏在演讲中给出他对大模型产业的判断:大模型产业正沿着两条路径发展,一是向上突破,推高智能上限;二是向实扎根,释放产业价值。“在大模型这两个发展方向上,我们都在向前推进。一方面,我们会持续投入,研发下一代更前沿的基础大模型。另一方面,我们会坚持‘模体并行、协同进化’理念,让大模型为应用而优化。”
这并非一次即兴表态。回看百度过去一年的动作,两条线的分工已经相当清晰:基础模型侧,今年1月文心5.0正式版上线,5月文心5.1发布,凭借多维弹性预训练技术将总参数压缩至约8000亿、激活参数压缩至约360亿,仅用业界同规模模型约6%的预训练成本,在LMArena搜索榜上位列国内第一、全球第四;应用模型侧,百度早在组织架构上就做了对应安排——设立基础模型研发部(BMU)与应用模型研发部(AMU),应用模型研发部由贾磊负责,直接向李彦宏汇报。本届大会上正式发布两款应用模型的,正是应用模型研发部负责人贾磊。
所谓“模体并行”,可以理解为“模型”与“体(应用载体/智能体)”并行推进、互为反馈:模型不再单纯追求榜单分数,而是围绕搜索、视频创作等已验证场景做专项优化;应用侧的真实调用数据又反过来牵引模型迭代。这是典型的“以应用为驱动”的模型策略,李彦宏此前在接受采访时也曾明确阐述过这一思路:不追求面面俱到,而是针对搜索、数字人等核心应用场景训练模型在关键技能上表现出色。
文心闪电:为搜索而生的推理效率革命
第一款发布的文心闪电深度思考模型,最初是为百度搜索业务研发的。随着搜索产品从传统信息检索向智能问答、智能体和复杂任务执行演进,模型既要理解需求、完成推理、具备工具调用能力,又要满足海量用户对响应速度的要求——效果与成本的矛盾在这里最为尖锐。
百度给出的解法是对传统Transformer架构动刀:自研BSA(Baidu Sparse Attention)稀疏注意力技术,在解码过程中根据历史输出和当前状态对KV缓存进行反馈式压缩,减少历史信息存储所需的计算资源,并可兼容DSA、HCA等高压缩自注意力机制;同时提出快慢思考协同的Looping方案——快思考模型响应实际业务请求,慢思考模型作为判定模型持续提供反馈。
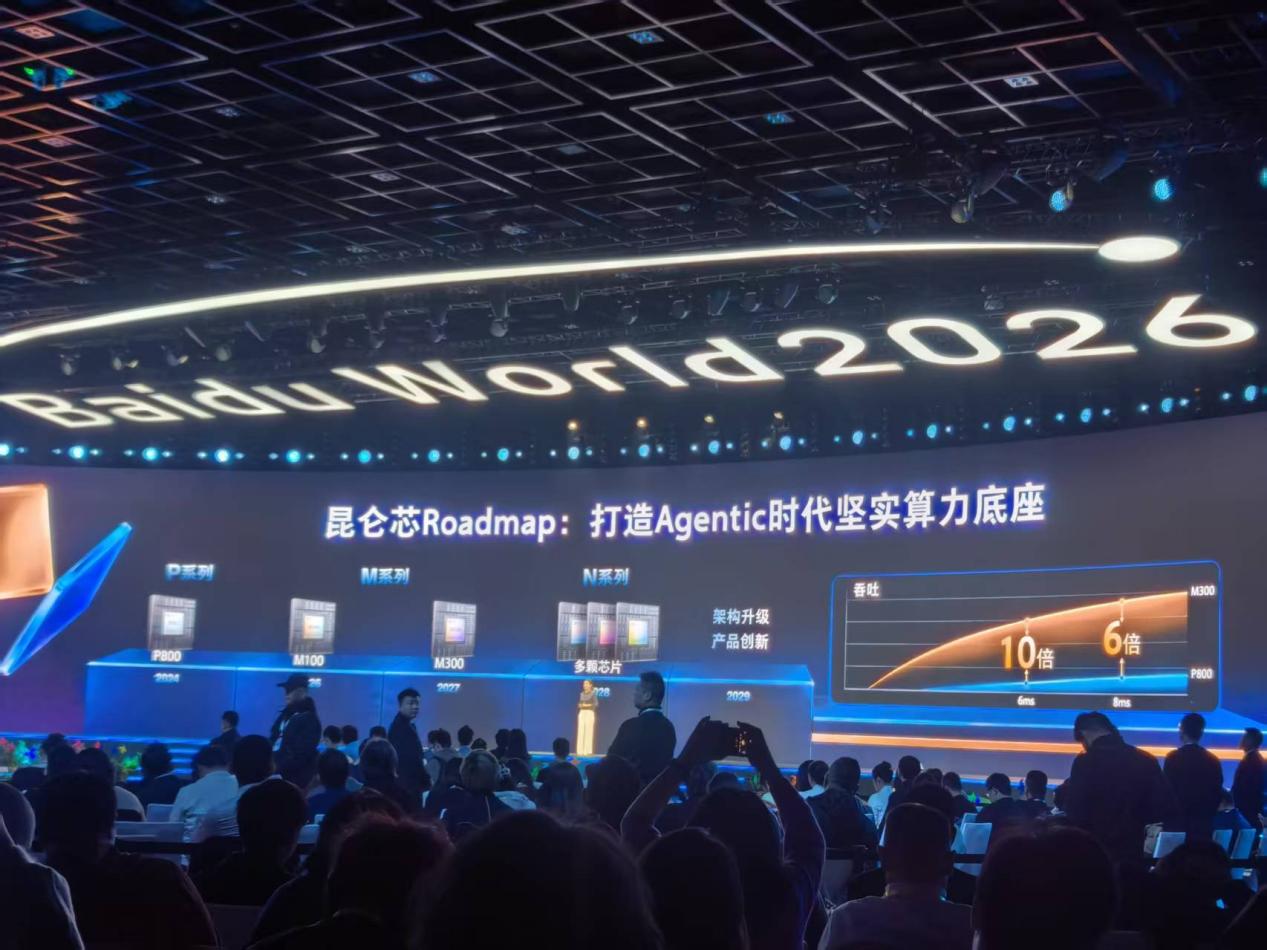
效率账本是这款模型最值得企业关注的部分:借助BSA以及与昆仑芯的协同优化,文心闪电可在昆仑芯上实现单机八卡高速推理,官方披露其模型ROI较同类芯片提升50%,推理引擎成本降低30%以上。目前该模型支持思考与非思考两种模式,覆盖编程、逻辑推理、智能体及文本处理等任务。这组数据背后的含义是:国产算力与模型协同优化后,推理侧的成本曲线正在被显著压低——对于计划将大模型嵌入高频业务流程的企业,推理成本每下降三成,可行场景清单就扩大一圈。
文心一镜:把情感表达做成可计量的生产能力
第二款文心一镜微表情大模型,瞄准的是AI视频创作中的情感表达难题。传统AI视频生成能完成画面与人物动作,但在细腻表情、情绪变化和长语音配音上始终存在短板。文心一镜采用文本、视觉、语音三态一体建模,支持最长4000字的文本驱动,构建了覆盖6大维度、200个子维度的细粒度描述体系,可将文本中的复杂情感转化为人物面部表情、肢体动作与情绪变化;配音侧推出“篇章级配音”技术,按完整剧本整体配音,实现声音一次生成、音色统一、节奏连贯,取代了传统的约30秒片段分别生成再拼接的方式。
成本与速度指标同样明确:官方称其视频生成成本较业界降低50%,极速版本可实现1:1实时生成——生成1分钟视频约需1分钟。在本次大会上,数字人智能体百度一镜同步推出“短漫剧Studio”,覆盖创意、剧本、分镜到成片的一站式创作链路,基于自研视频生成模型成本仅需每秒0.2元;大会现场展示的数字人希加加专访李彦宏的视频片段,即由百度一镜生成。
对内容产业而言,这类指标的意义在于把“情感表达”从不可量化的艺术问题,转化为可计价、可排产的生产能力。当分钟级视频的边际成本降到每秒0.2元的量级,短剧出海、数字人直播、批量本土化适配等场景的商业模型将被重新测算。
词元所与千帆:从模型供给走向可信交易的基础设施
发布会另有一项容易被低估的基础设施动作:百度正式推出大模型交易平台“词元所”。李彦宏指出,今年前9个月几乎每天都有新模型发布,但市面上的词元中转站并不对模型效果、服务稳定性负责,“同一款模型,有的贵有的便宜,来源五花八门,质量参差不齐。选来选去,就是不放心、不敢用。”
词元所定位为“大模型的交易所”,主打“验真”与“征信”两大能力:通过模型指纹比对、能力测试、性能与可用性测试进行资源核验,并以定期抽检拨测、全链路实时监测调用等方式为模型提供商建立信用评级。据现场披露,词元所上线一个月以来已入驻供应资源超100个,日均调用次数突破5000万,日均调用Token超7000亿。
这一动作与企业侧的痛点直接对应。当前词元经济正快速成型——国家数据局数据显示,今年3月我国日均词元调用量已突破140万亿;但计量可信、结算可信、流通可信三大缺口普遍存在,企业大规模采购词元面临“既是运动员又是裁判员”的信任困境。百度把“验真+征信”做成平台能力,本质上是在为词元流通补上第三方信任层。而千帆平台作为承载入口,此前已服务超过46万家企业、支持构建超130万个智能体,并持续引入Kimi、GLM等第三方开源模型扩大生态——应用模型上架千帆开放API,等于直接接入这套已经成型的企业级分发网络。
智能组织:AI落地的“最后一公里”在组织
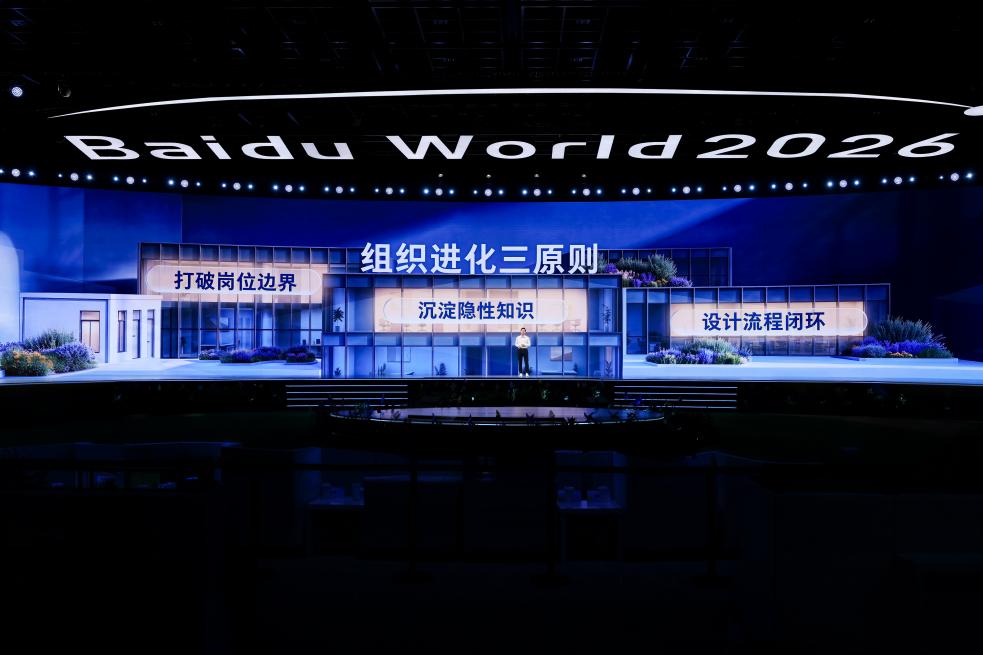
本次大会另一个关键词是“智能组织”。李彦宏提出,人工智能的下一幕是智能组织:“如果说人工智能是新电能,那么,智能组织就是AI时代新的厂房,是生产力真正发生的地方。”
支撑这一判断的是百度内部的组织数据:智能体完成的有效任务数从每周8.4万个增长到一周超过100万个;百度已建设4300个Workspace,沉淀组织Skill超过2万个;百度搭子团队半年迭代160多次,90%的代码、50%的对外传播物料由搭子生成。用李彦宏的话说,就是“让一个人的经验,成为整个组织的能力”。
从企业数字化转型的视角看,这是本场发布会最值得深思的部分。基础模型与应用模型解决的是“能力供给”,而组织层面的Skill沉淀、Workspace协作与智能体任务编排,解决的是“能力消化”。过去两年大量企业的实践已经证明:模型能力再强,若组织流程、数据治理和岗位分工不随之调整,AI投入就难以转化为经营结果。百度把“智能组织”提升为战略叙事,等于承认了一个行业共识——AI竞争的下半场不在参数表上,而在组织能力上。
分析视角:透过发布会看百度AI的处境与打法
把本次发布会放回百度整体的业务坐标系,其意图更为清晰。2026年第二季度,百度核心AI驱动业务收入达到125亿元,同比增长25%,占百度一般性业务收入的50%,连续两个季度占比过半;但同期在线营销服务收入同比下降19%,传统广告业务承压明显。换言之,百度比任何时候都更需要AI新业务放量,而AI业务从“基础设施收入”走向“应用收入”的转化,恰恰依赖应用模型与行业场景的贴合度。李彦宏在二季度财报电话会上那句“我们有信心加快迭代,让文心重回基础大模型的第一梯队”,与本届大会“模体并行、协同进化”的提法,构成了同一场战略的两个声部:前者回应基础模型的追赶压力,后者宣示应用侧的差异化路线。
需要指出的是,这条路线并非没有挑战。其一,应用模型的护城河来自场景数据与工程适配,竞争对手同样在快速复制“基础模型+应用模型”的双线打法;其二,词元所要建立的第三方信任机制,其公信力取决于平台中立性,而百度既做模型又做交易平台,如何自证公允有待观察;其三,推理成本下降30%、视频成本下降50%等均为官方口径,实际效果仍需企业客户在生产环境中验证。
但方向本身是清楚的:当行业从“拼参数”转向“拼落地”,谁能把模型能力、算力成本、可信交易与组织消化四个环节串成闭环,谁就更有可能把AI从演示做成生意。百度世界2026给出的答案是——模型为应用而优化,应用为组织而沉淀。这个答案是否成立,接下来一个季度千帆平台上的调用量与企业复购数据,会是比发布会更诚实的裁判。