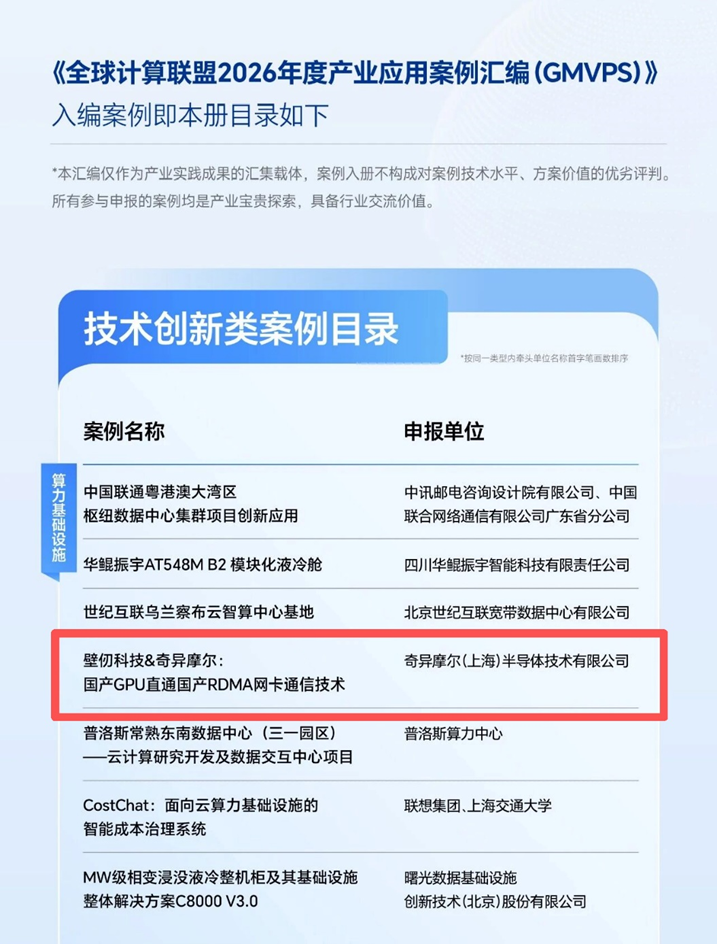
10月8日,《全球计算联盟2026年度产业应用案例汇编》入编目录正式发布。由奇异摩尔与壁仞科技联合推出的国产GPU直通国产RDMA网卡的IBGDA解决方案,从众多征集案例中脱颖而出,成功入选案例汇编。此次入选,标志着国产GPU与国产RDMA网卡在直通互联与软硬件协同方面取得实质性突破,也意味着该方案的技术先进性、生态适配性和产业应用价值获得行业认可。
据了解,“全球计算联盟年度产业应用案例汇编征集(GMVPS)活动”由GCC(全球计算联盟)组织,旨在为沉淀一线产业实践、共享落地经验而搭建的平台。GMVPS作为全球计算联盟年度产业专项,已连续举办多届,累计收录超250项全球产业应用与技术实践内容,已成为产业创新发展的风向标。
(图源:全球计算联盟GCC)
破解“通信墙”,从IBRC到IBGDA
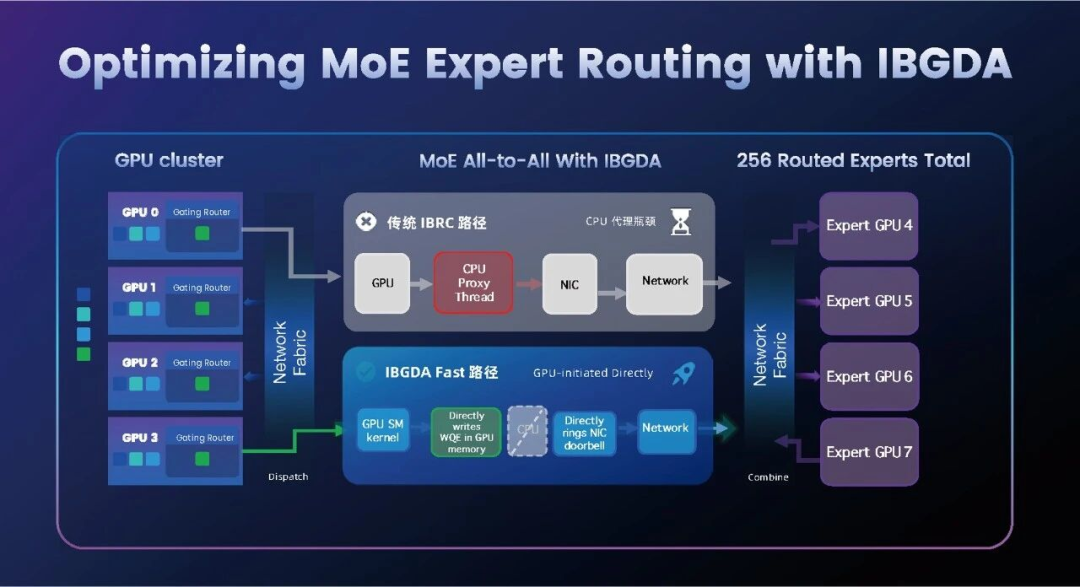
大规模 AI 集群中,GPU 跨节点数据传输传统依赖 IBRC机制。在该机制下,GPU 向远端传输数据需要一条冗长的中转链路:GPU 将数据写入共享内存后,通知 CPU 侧进程;由 CPU 配置工作队列,向网卡下发指令;网卡从 GPU 显存读取数据并完成发送;传输结束后,再经由 CPU 回调通知 GPU。由此可见,跨节点通信不仅受限于网卡带宽,还引入额外的显存/内存拷贝、CPU 参与和同步开销。对于 PD 分离下长上下文、多轮对话和 Agent 高频调用所产生的 KV Cache 搬运而言,这种 CPU 中转路径会进一步放大时延与吞吐损耗,使“通信墙”成为限制解耦收益和集群效率的关键瓶颈。
(图源:奇异摩尔)
奇异摩尔网络技术 VP 叶栋指出,“整个流程里,CPU 充当‘中间人’。GPU 准备发送数据先告知 CPU;CPU 下发指令给网卡;网卡读取并传输数据;传输完成通知 CPU;CPU 再反馈给 GPU。这套代理机制在小数据块传输场景下,开销问题尤为突出。MoE 模型推理,正是小包、高频通信的典型场景。当 GPU 每次仅传输少量数据时,CPU 代理产生的开销甚至高于数据本身的传输耗时,持续的交互等待,会让 CPU 处理能力成为集群整体吞吐瓶颈。”
因此,优化GPU与网卡之间的数据通路,尤其是缩短通信控制路径,成为提升系统级效率的关键。在此背景下,IBGDA(InfiniBand GPU Direct Async)技术应运而生,其核心思路是彻底移除 CPU 这一中间环节,实现 GPU 与网卡直接互操作。工作流程得到大幅简化:GPU 可直接生成通信任务、触发网卡门铃;网卡收到指令后,直接读取 GPU 显存内的数据完成发送;传输完毕后直接将状态回写至 GPU,全程无需 CPU 参与。
IBGDA在大规模、延迟敏感的AI推理场景中优势显著。根据英伟达的官方数据显示,在NCCL(NVIDIA集合通信库)中使用IBGDA,在大规模集群上进行All to All通信时,延迟最高可降低75%。因此,这项技术对于需要大量细粒度通信的HPC和AI大模型推理场景至关重要。
数据搬运成为新瓶颈
AI大模型推理通常分为Prefill和Decode两个阶段,其中Prefill是计算密集型,负责处理整个输入序列并生成首个Token和KV Cache;Decode是访存密集型,逐个生成后续Token,并不断读取KV Cache。PD分离架构将这两个阶段拆分到不同的GPU上,以解决资源争抢问题,但它也引入了一个核心挑战:Prefill阶段产生的KV Cache必须通过网络传输给Decode节点。随着行业普遍进入长上下文、多轮对话和 Agent 高频调用的时代,KV Cache 的大小也急剧膨胀,其搬运成本已演变为无法回避的工程难题。
传统的 TCP/IP 协议栈已完全无法胜任传输挑战,诸多机构在线上推理系统中引入 RDMA,用于承担 KV Cache 的高速传输,从而实现最大化推理性能与资源利用率。NVIDIA Dynamo 官方文档的实测数据给出了直观的对比:使用 TCP 进行 KV Cache 传输会导致 200 至 500 倍的首 Token 时延性能退化,实测 TCP 的 TTFT 高达约 98 秒,而 RDMA 仅需 200 至 500 毫秒。
IBGDA是RDMA技术面向GPU-centric通信场景的重要演进方向,而AI SNIC则是承载该技术的重要硬件。IBGDA对PD分离架构的赋能及KV Cache传输瓶颈的优化主要体现在三个方面:其一是压缩跨节点KV传输的关键路径,无需CPU逐次介入通信提交,从而减少CPU调度和代理线程带来的延迟开销;其二是提升高并发、细粒度通信效率,PD分离架构下KV Cache的传输可能涉及大量分散的内存块,IBGDA优化的GPU侧通信提交路径有助于缓解CPU代理线程的性能瓶颈,实际收益取决于数据布局及请求聚合策略;其三是结合NVMe-oF、GPUDirect Storage(GDS)等存储直通技术,支持将远端存储中的KV Cache高效加载至Decode节点的GPU显存,并结合GPUDirect RDMA及GPU P2P等机制实现GPU间直接数据传输,减少不必要的数据复制和搬运开销,构建高效的GPU-centric数据通路。
总体而言,IBGDA技术继承了RDMA高带宽、低CPU占用以及GDR的GPU内存直接访问优势,并通过将控制面也卸载到GPU,实现了更极致的低延迟通信。
奇异摩尔携手壁仞科技
国产IBGDA方案落地
在国际方案与国产方案的对标中,英伟达凭借其GPU与ConnectX系列网卡的深度协同,率先实现了IBGDA方案,为大规模AI推理场景提供了成熟的延迟敏感型通信能力。而国产集群要实现同等能力,国产化GPU需先满足对类NVSHMEM编程及最新NCCL 通信库以及DeepEP等集合通信库的支持,并与国产RDMA网卡在软硬件层面完成适配,方能实现GPU直通网卡的高效通信。然而,目前国产GPU支持IBGDA主要完成的是与英伟达网卡的适配,但国产RDMA网卡与国产GPU实现网卡直通的规模化落地案例仍相对罕见,这一环节仍是制约国产化集群通信效率提升的短板。
(图源:奇异摩尔)
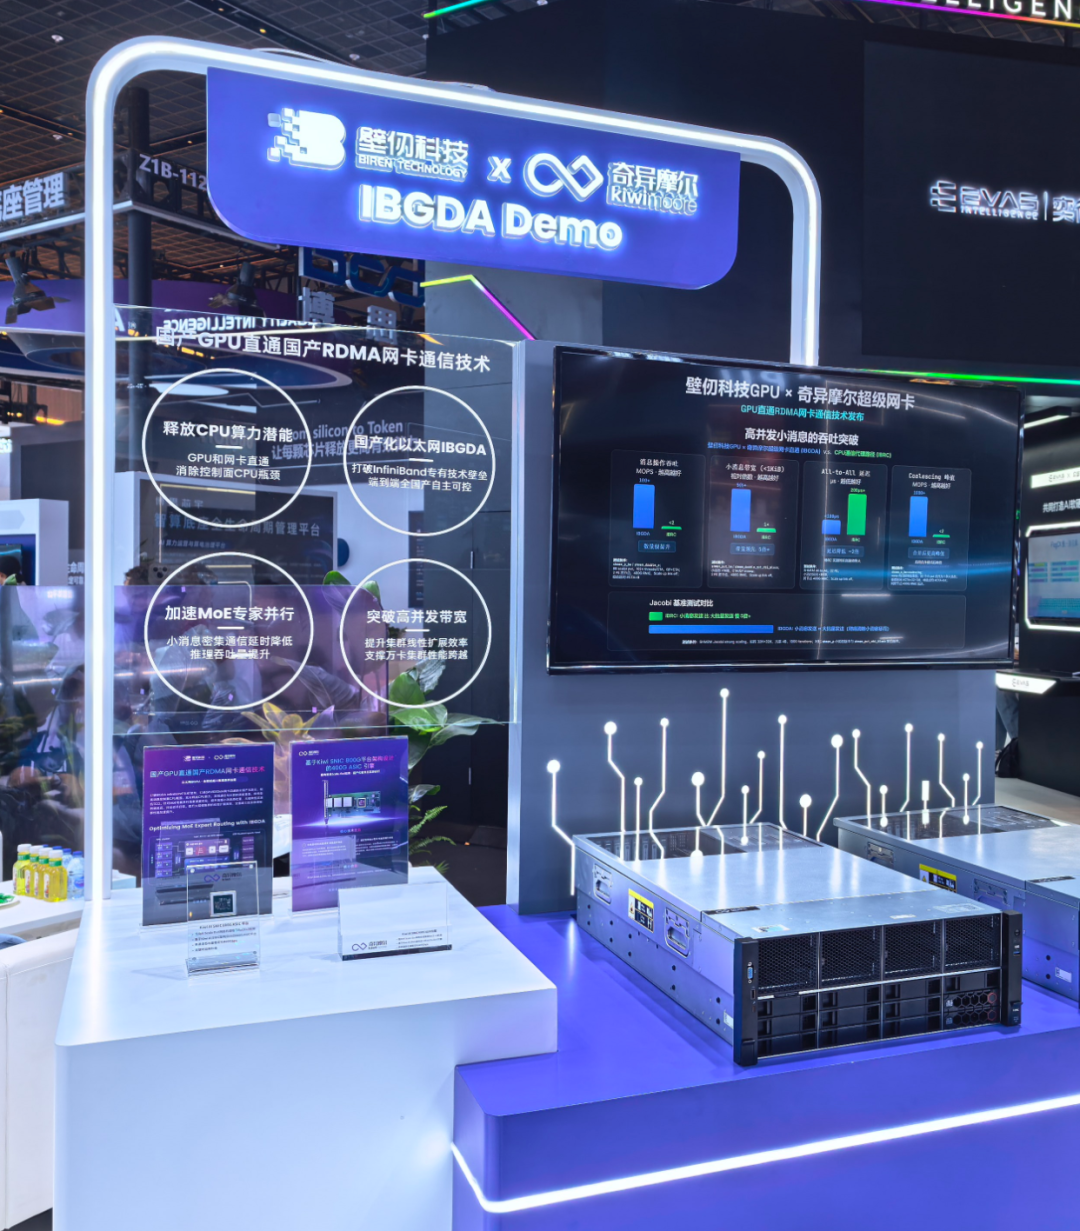
奇异摩尔携手壁仞科技推出的国产GPU直通国产RDMA网卡的IBGDA解决方案,填补了国产算力体系空白。另外实测表明,IBGDA相较传统IBRC在小包、高频、强同步场景下呈现代际优势——单次小消息带宽显著跃升,原始小包发送及合并发送的吞吐量均实现质的提升。在相同测试条件下,消息操作吞吐方面,IBGDA方案达到100+ MOPS,而IBRC不足2 MOPS,实现数量级跨越;小消息带宽(<1KiB)方面,IBGDA相对IBRC实现5倍以上领先;All-to-All集合通信延迟方面,IBGDA稳定控制在100µs以内,IBRC则超过200µs,延迟降低约50%,且IBRC实测时延高、波动率大;Coalescing合并发送场景下,IBGDA峰值达到1000+ MOPS,而IBRC同样不足2 MOPS,合并后峰值进一步拉大差距。
Jacobi基准测试中,IBRC方案小消息发送比大批量发送慢5倍以上,“小包惩罚”效应显著;而IBGDA方案小消息发送与大批量发送性能基本持平,彻底消除了这一长期存在的“小包惩罚”效应,确保大规模AI推理中频繁出现的小包同步操作不再成为性能瓶颈,为国产算力集群规模化部署提供了坚实的通信底座。
值得一提的是,该方案基于奇异摩尔Kiwi SNIC 800G平台架构设计的单通道400G RDMA ASIC引擎,其已完成软硬件全栈协同开发,原生支持IBGDA机制,并兼容专为MoE模型优化的集合通信库(对标DeepEP)。该方案建立在开放的以太网生态之上,具备以太网部署灵活、成本可控的天然优势,为国产算力集群提供了一个兼具高性能与自主性的Scale-out网络选择。
深耕互联,协同共赢
《全球计算联盟2026年度产业应用案例汇编》聚焦全球计算产业中具有代表性的应用实践。奇异摩尔与壁仞科技联合推出的IBGDA方案此次入选,体现了产业界对国产算力互联技术创新的认可,也反映出算力基础设施正在从“堆叠算力”迈向“系统级优化”的新阶段。
对奇异摩尔而言,这一案例是其在高性能互联、算力集群通信和国产算力生态建设方面的重要实践。与此同时,奇异摩尔持续深化与开源生态的协同,加速 IBGDA 在国产算力产业的适配落地。在国产算力生态不断完善的进程中,奇异摩尔将继续围绕算力互联关键瓶颈,推动更多可验证、可部署、可规模化的解决方案落地,为构建高效、开放、自主可控的算力基础设施贡献力量。