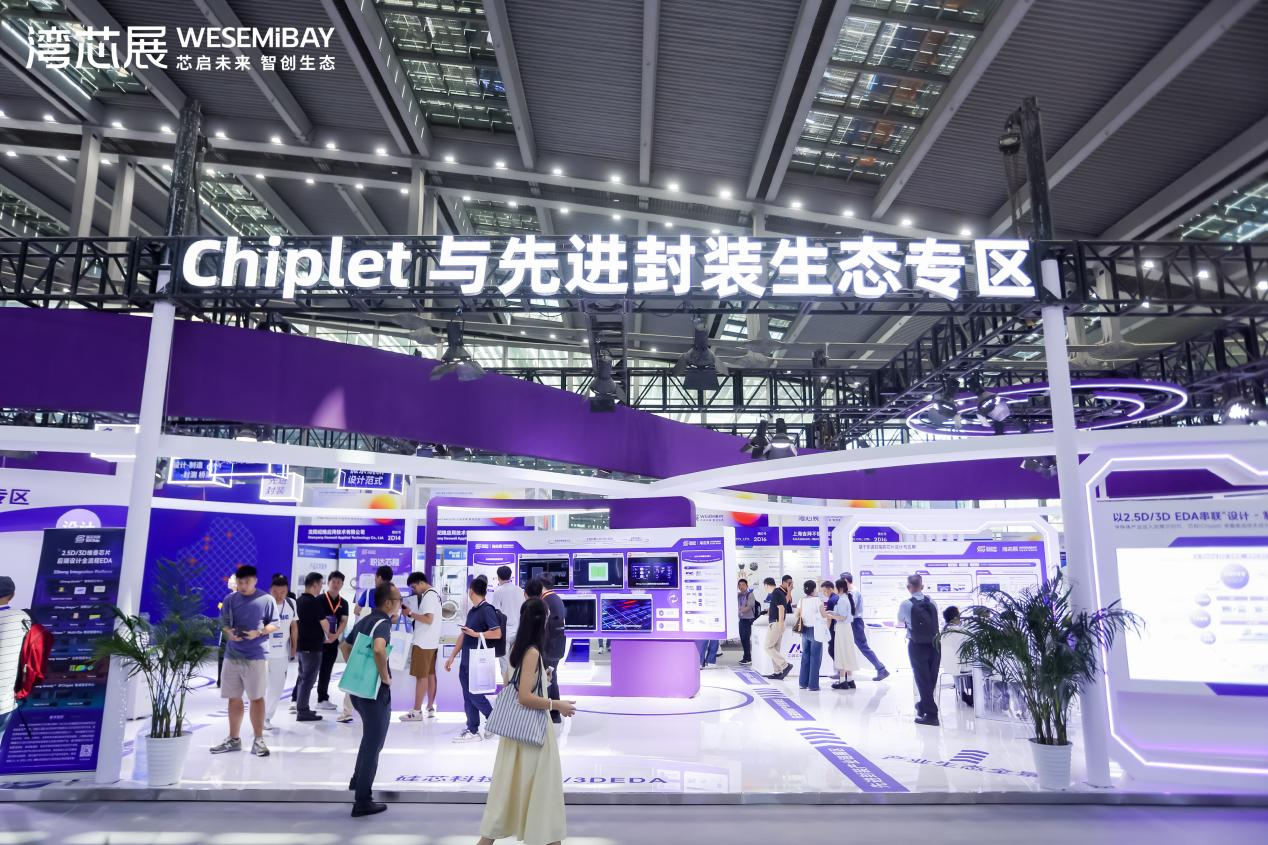
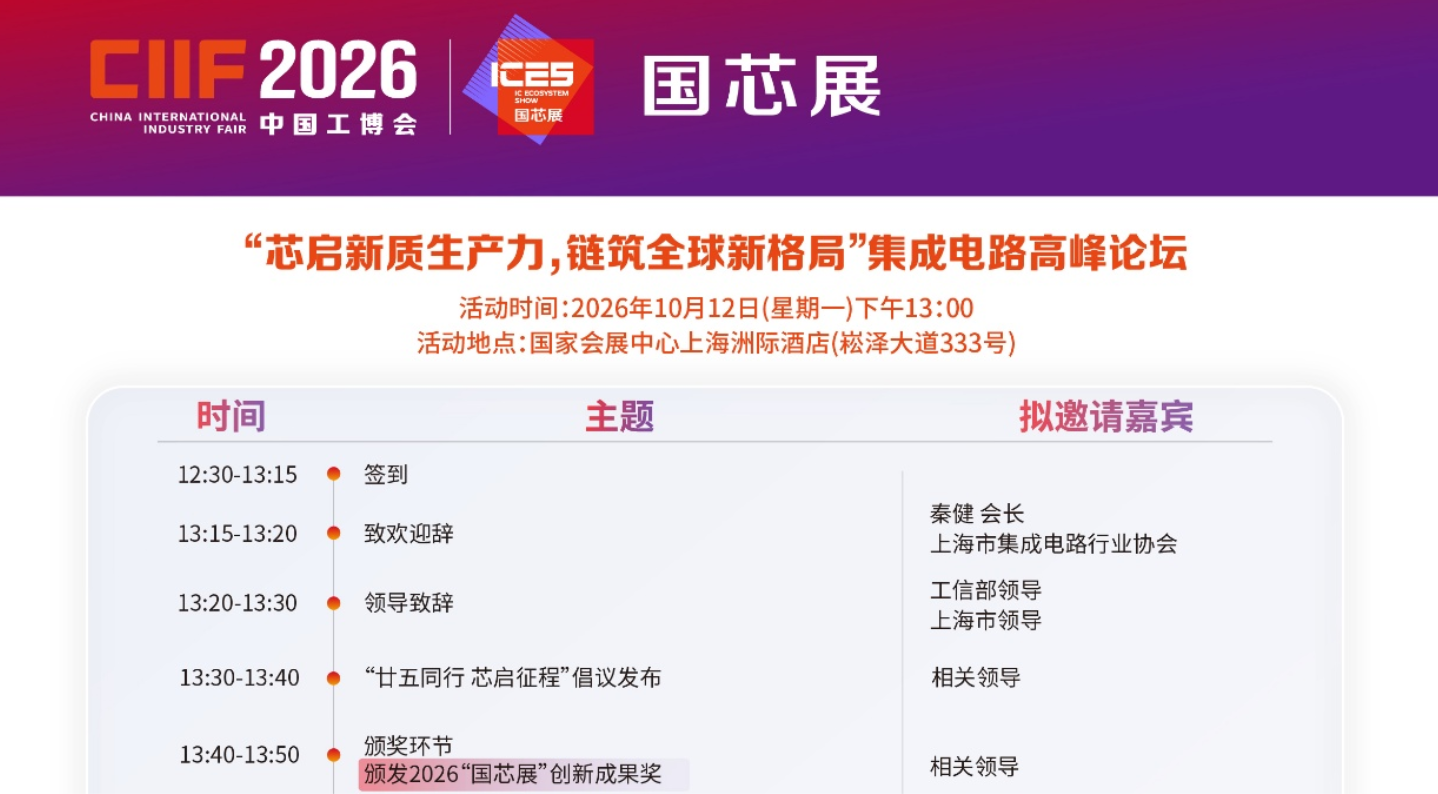
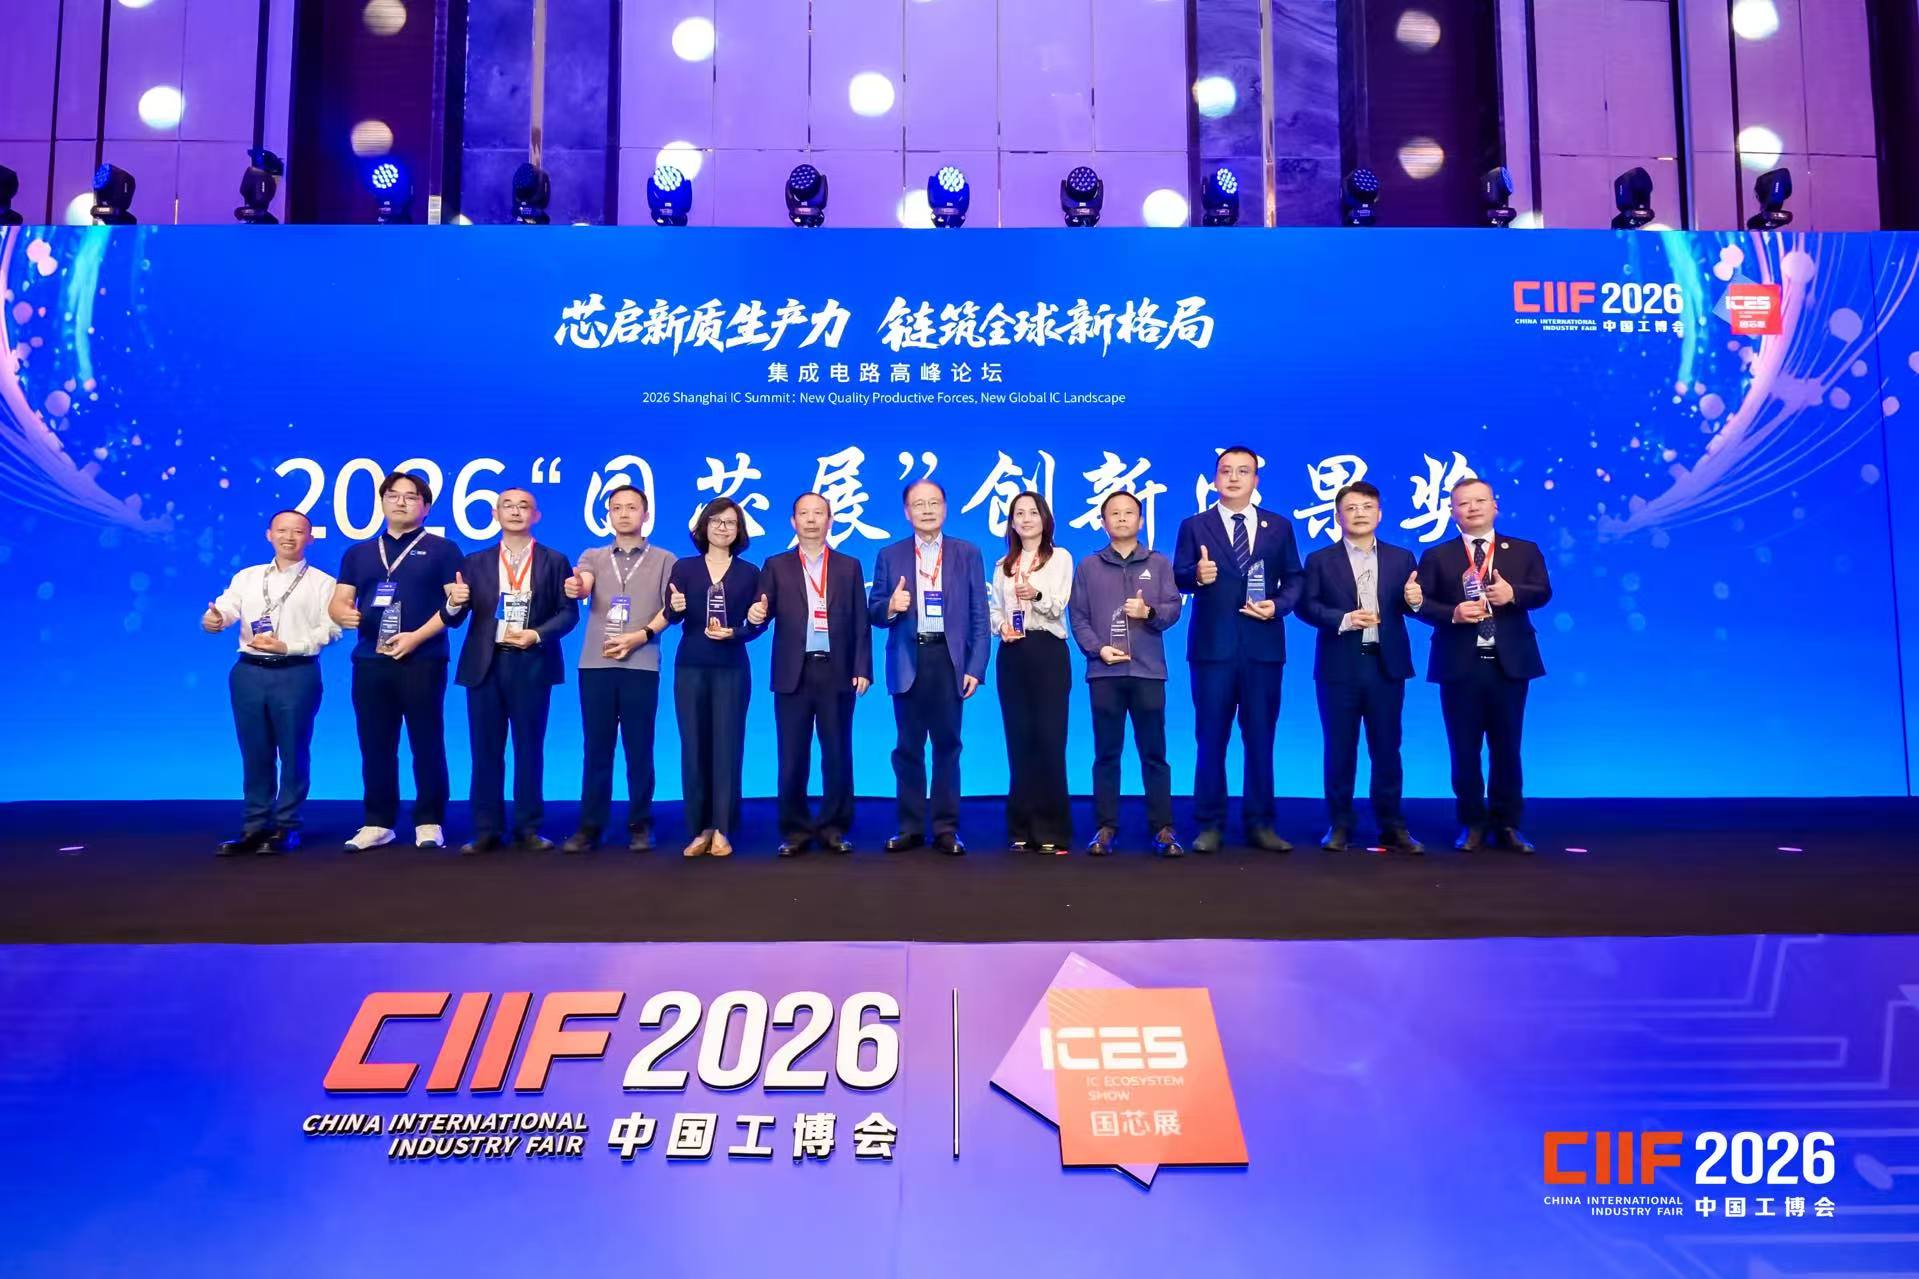
10月12日,以“智能经济,智造无界”为主题的第二十六届中国国际工业博览会在国家会展中心(上海)开幕。沐曦股份(688802.SH)携全栈GPU产品矩阵及产业生态成果亮相本届工博会集成电路展(国芯展),通过“芯算基座”、“开源工坊”、“万象应用”三大展区,集中展示从GPU芯片、服务器到超节点的算力产品体系,以及开放软件生态与行业应用的创新实践。展会期间,沐曦曦索X302科学智能GPU荣获2026国芯展创新成果奖,彰显公司在国产高性能GPU领域的持续创新能力。
硬核筑基:全栈算力矩阵集中亮相
在“芯算基座”展区,沐曦股份集中展示曦思N300、曦云C600、曦索X301及X302四款GPU产品,分别面向大模型推理、AI训练与推理、科学智能等不同计算需求,全面呈现公司在高性能GPU领域的技术布局。
其中,此次获奖的曦索X302科学智能GPU,基于国产先进工艺制造,采用沐曦自主知识产权的全新一代计算架构,具备多精度混合算力与大容量高带宽显存,兼顾AI计算与高精度科学仿真需求。产品搭载自研MetaXLink及MetaXLink高速互连技术,支持128卡超节点低时延组网,配合兼容主流GPU生态的MXMACA软件栈,可广泛支持气象海洋、流体力学、分子动力学等经典科学计算,以及材料科学、生命科学等AI for Science(AI4S)前沿科研场景。
从单卡走向系统,曦景S600超节点同样是本届展会的重点展品。作为面向大模型训练、推理及智算中心建设打造的系统级算力产品,曦景S600采用整机柜一体化设计,单机柜集成64卡全互连,支持横向扩展至万卡规模。其创新的“三0设计”——计算节点0线缆、交换节点0线缆、计算与交换节点之间0线缆,结合解耦模块化架构,有助于降低大规模智算集群的部署与运维成本。
展区还展示了沐曦股份与东方算芯联合推出的异构算力机柜。该产品融合曦云C600 GPU与3D堆叠近存计算AI芯片DF1000,是对以异构协同提升云端推理效率路径的全新探索。
生态共建:开放软件体系加速创新协作
在“开源工坊”展区,沐曦股份围绕“每个Token背后,都是一次开源协作”的主题,联合国内外开源社区及生态伙伴,展示从基础软件、AI框架到模型应用的协同创新成果。
作为连接底层GPU硬件与上层应用的关键纽带,沐曦自研MXMACA软件栈高度兼容国际主流GPU生态,通过持续推进开源开放、模型适配与工具链优化,降低开发者的软件迁移和应用部署门槛。
从适配主流生态到深度参与开源共建,沐曦正持续完善自主可控、开放兼容的软件体系,让国产GPU更便捷地融入全球开发者生态,加速技术创新成果向实际应用转化。
千行赋能:“1+6+X”拓展产业应用边界
算力的价值,最终需要在真实产业场景体现。
在“万象应用”展区,沐曦股份围绕“1+6+X”产业生态战略,集中呈现国产算力的规模化应用成果。以自主GPU算力平台为基础,持续深耕金融、医疗健康、能源、教科研、交通、大文娱六大行业,并积极拓展具身智能、空天算力等前沿领域。
目前,沐曦股份已支撑10余个智算集群部署落地,产品与解决方案持续向更多行业场景延伸。随着人工智能与实体经济加速融合,产业客户对算力的需求正从单点性能延伸至系统效率、稳定运行、软件易用性和综合使用成本。围绕这一趋势,沐曦持续强化GPU芯片、软件栈、高速互连及计算平台的协同能力,推动自主算力从技术突破走向规模化应用。
从单卡到超节点,从开放生态到产业落地,本届工博会展现了沐曦股份不断完善的全栈算力技术体系。面向智能经济发展新阶段,沐曦将继续坚持自主创新与开放协作,以高性能GPU及系统级算力能力为基础,推动国产算力深度融入产业创新,为人工智能与实体经济融合发展提供坚实支撑。