无训练、无梯度,大模型首次“读改写”另一个神经网络的参数。
导语
麻省理工学院计算机科学与人工智能实验室(MIT CSAIL)的四位研究者于11月2日公布了一组实验:他们让OpenAI的前沿模型GPT-6 Astra直接读取并修改阿里通义千问开源模型Qwen3.5-0.8B的神经网络权重,在不重新训练、不计算梯度的情况下,仅改动约0.016%的参数,就把该模型在MATH-500数学基准上的准确率从7.9%提升到48.1%,约为原来的6倍。研究团队将这套方法命名为“权重空间编程”(Weight-Space Programming),成果以研究博客加开源实验日志的形式发布,尚未经过同行评审。VentureBeat率先报道,并称其“如同给神经网络做基因编辑”。
需要说明的是,这项实验提升的本质并非“给模型灌入了6倍数学知识”,而是解除了一处遮蔽模型已有能力的缺陷——研究团队自己明确划定了这条能力边界。
一、不训练、不算梯度:权重空间编程的Qwen实验
1.1 一个被死循环拖垮的小模型
Qwen3.5-0.8B是通义千问Qwen3.5系列中参数最小的开源模型,约8亿参数,采用Apache 2.0许可证,原生支持26.2万token上下文。这个小模型有一个官方模型卡中已经写明的弱点:在思考模式下容易陷入循环,反复生成相似内容,迟迟给不出答案。MIT团队的实验印证了问题的严重性——在最初的96个练习题回答中,有85个一直写到32,768个token的长度上限;在MATH-500评测中,93%的回答都撞到了这个上限。模型并非完全不会做题,而是“话说不完,答案没机会出现”。
1.2 Astra怎么找到并切掉那一刀
研究团队给GPT-6 Astra准备了一个可以直接读写权重的Python环境,并允许它使用GSM8K与MATH训练集中的练习题做有限次数的前向推理——禁止梯度下降,禁止传统训练循环,改什么、怎么改,全部由Astra自己分析决定。Astra把重复循环一路追踪到第15层和第19层的多层感知机(MLP),定位到这两层写入的一个与重复相关的数值方向,随后把这个方向从两层的64个输出列中减去,合计修改131,072个权重,约占模型全部参数的0.016%。VentureBeat报道将其比喻为“如同给神经网络做基因编辑”;研究博客的原始表述则是“如同从权重中删除单一方向来移除一种行为”。
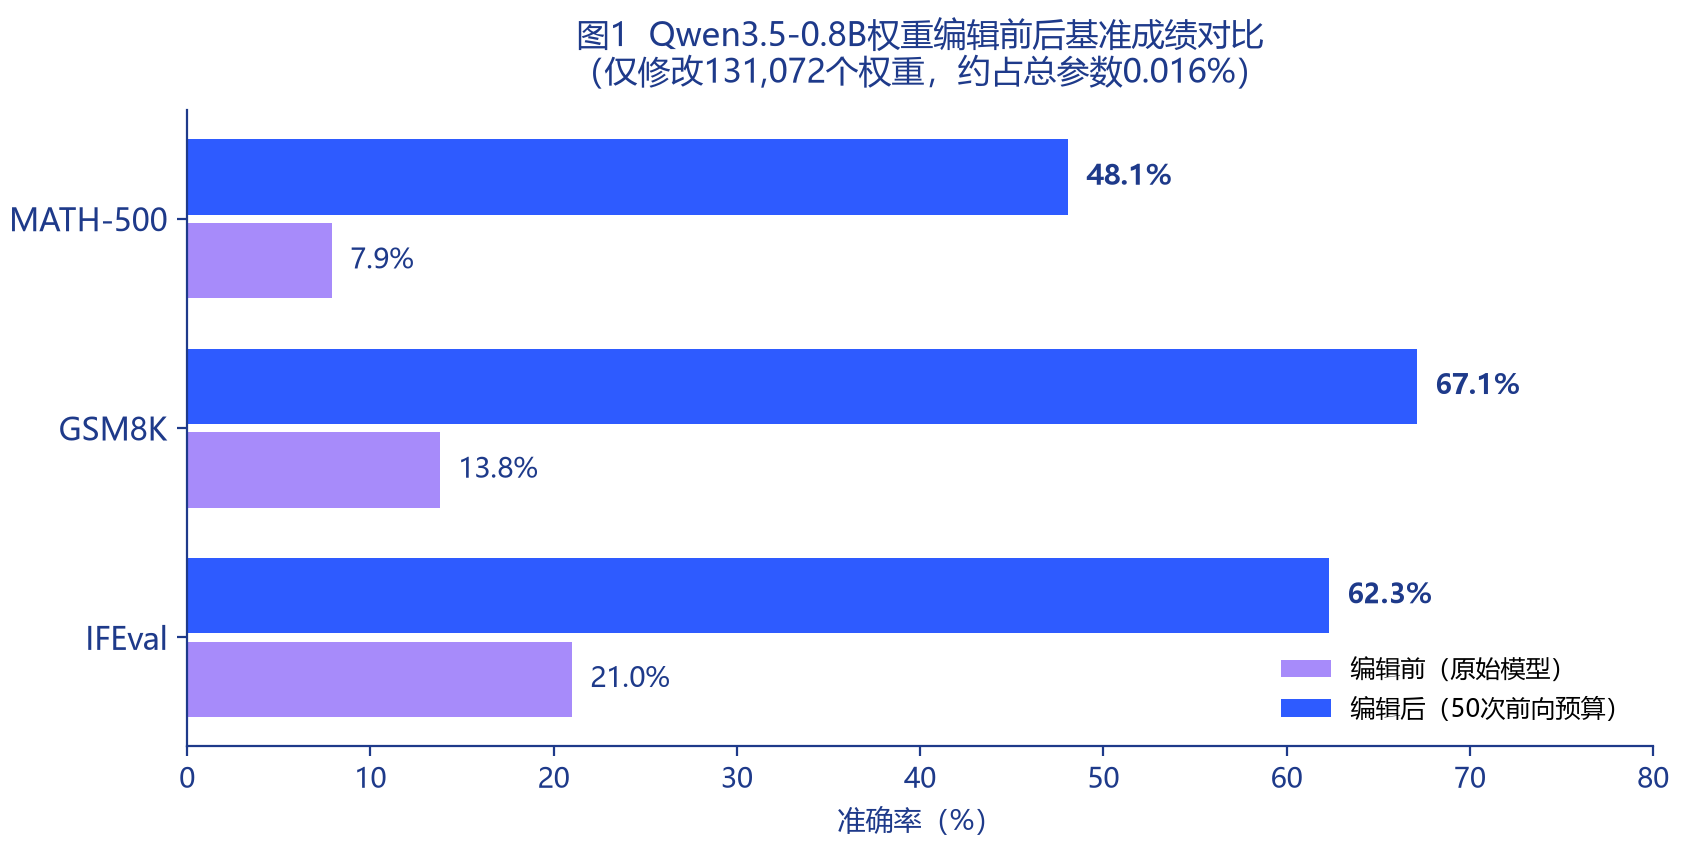
图1 Qwen3.5-0.8B权重编辑前后基准成绩对比
1.3 成绩单:三个基准同步跃升
在允许50次前向推理预算的最强一次运行中,编辑后的模型在MATH-500上从7.9%升至48.1%(约6倍),GSM8K从13.8%升至67.1%,IFEval指令遵循从21.0%升至62.3%——指令遵循并不在优化目标之内,却同步提升近3倍,说明修复循环的效果泛化到了数学之外。最直观的变化是:MATH-500回答触及token上限的比例从93.0%降到33.1%。
二、“6倍”的另一面:修复而非注入
2.1 预算梯度揭示了跃迁的条件
这不是一次轻松的手术。研究团队分别给了Astra 10次、25次和50次前向推理预算:10次预算下MATH-500只升到12.3%,25次升到14.1%,只有50次预算的那次运行才跃升到48.1%。而且三档是各自独立的一次运行,50次预算的结果未经重复验证。公开日志显示,最强的一次运行总共花了20.3小时,包括158轮对话和80次Python执行,其中4.7小时还在等待服务中断恢复。“0.016%”听起来很轻,找到那一刀的过程却仍然依赖搜索和试错。
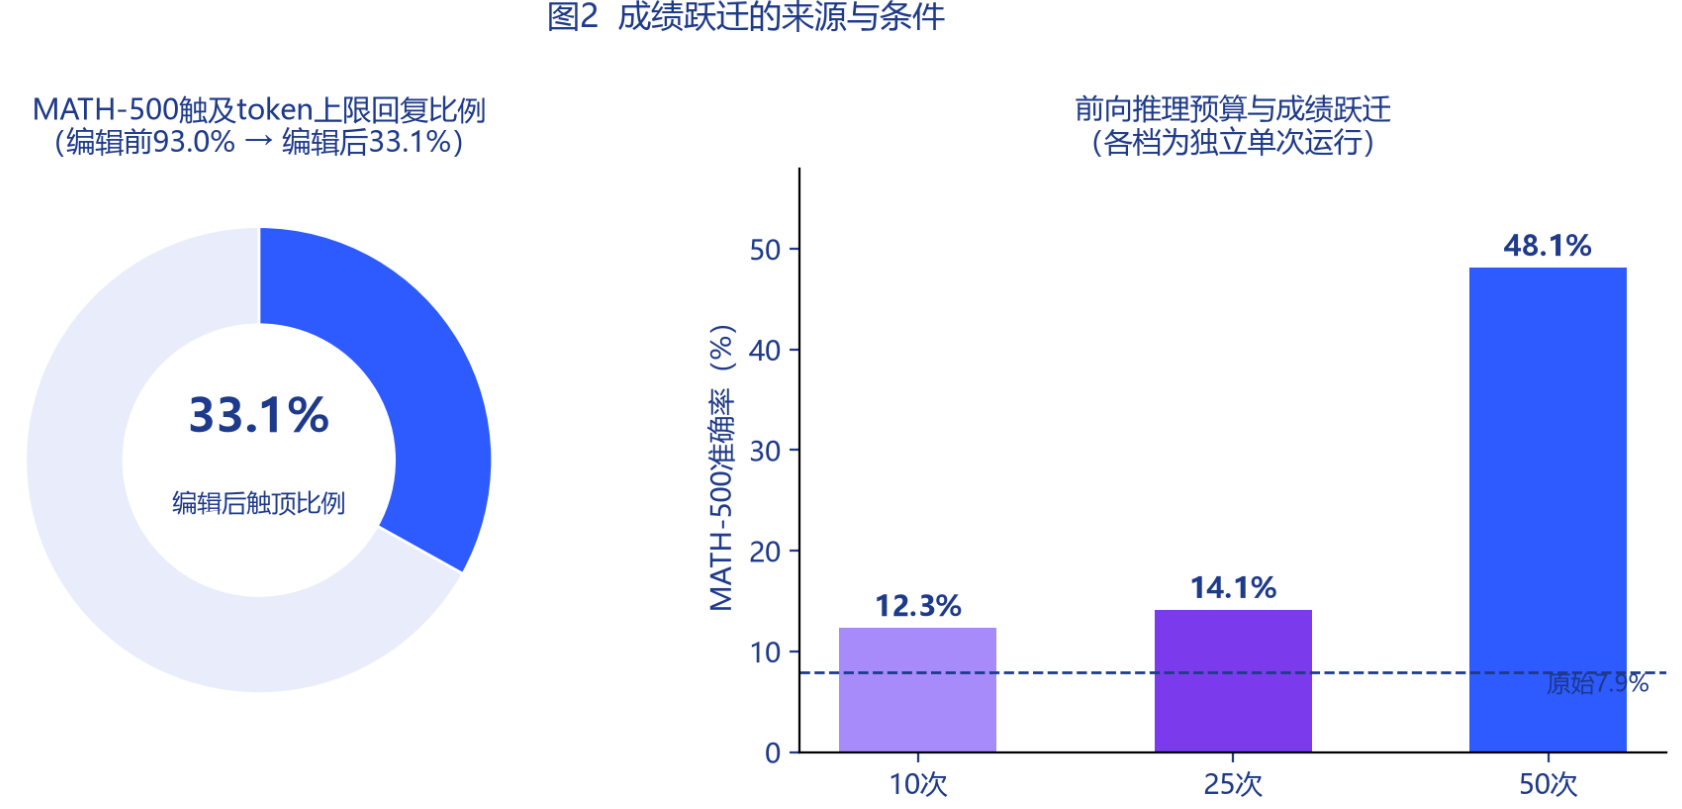
图2 触顶比例变化与前向预算-成绩关系
2.2 对照实验划定的能力边界
研究团队自己做了关键的对照实验:Gemma 3 270M是一个很少陷入循环的小模型,只有约8.5%的回答触及长度上限。Astra在它的权重里只能看到普通的算术错误和代数错误,找不到一个可以关闭的单一故障方向,所有修改都没有让MATH-500提高超过约1个百分点。研究博客的结论很克制:“编辑权重可以移除一个遮蔽能力的障碍,但不能增加模型原本缺乏的能力。”VentureBeat同样强调,实验并未证明Astra向Qwen注入了6倍的数学知识,也没有证实伴随6倍准确率提升的是6倍的支出削减。换言之,“6倍”描述的是一次模型修复前后的分数变化,而不是六倍数学智能被装进了模型。
三、从读权重到写权重:一条完整的能力路径
Qwen实验只是整个研究的一环。团队实际测试了三种能力:读、修、写。
读权重:四个架构、输入通道和动作选项完全相同的PPO游戏网络,Astra在不知道候选名单、也不能运行网络的情况下,仅凭原始权重正确辨认出Breakout(打砖块)、Pong(乒乓)、Pac-Man(吃豆人)和Freeway四个游戏;对三个移除了输入输出层的720万参数小语言模型,它也在两轮尝试内认出了各自训练用的语言,并找出了全部归纳头。
修权重:一个用PPO训练的小车爬坡策略总是直接冲坡然后卡住。Astra看过权重、场景描述和一段失败轨迹后,一次回复给出补丁,只改了3.5%的权重,就让小车在1,024次测试中全部成功——模型没能通过训练学会的动作顺序,被直接写进了权重。
写权重:在MinAtar小游戏实验中,Astra拿到游戏规则、源代码和指定网络结构,不给训练数据、损失值、梯度和工具,要求它从零写出一个能用的网络。它生成的Breakout网络平均得分517.4,而PPO训练5亿步的对照网络只有25.3分,约20倍的差距;不过在Seaquest和Asterix两个游戏上,它仍落后于5亿步PPO基线。
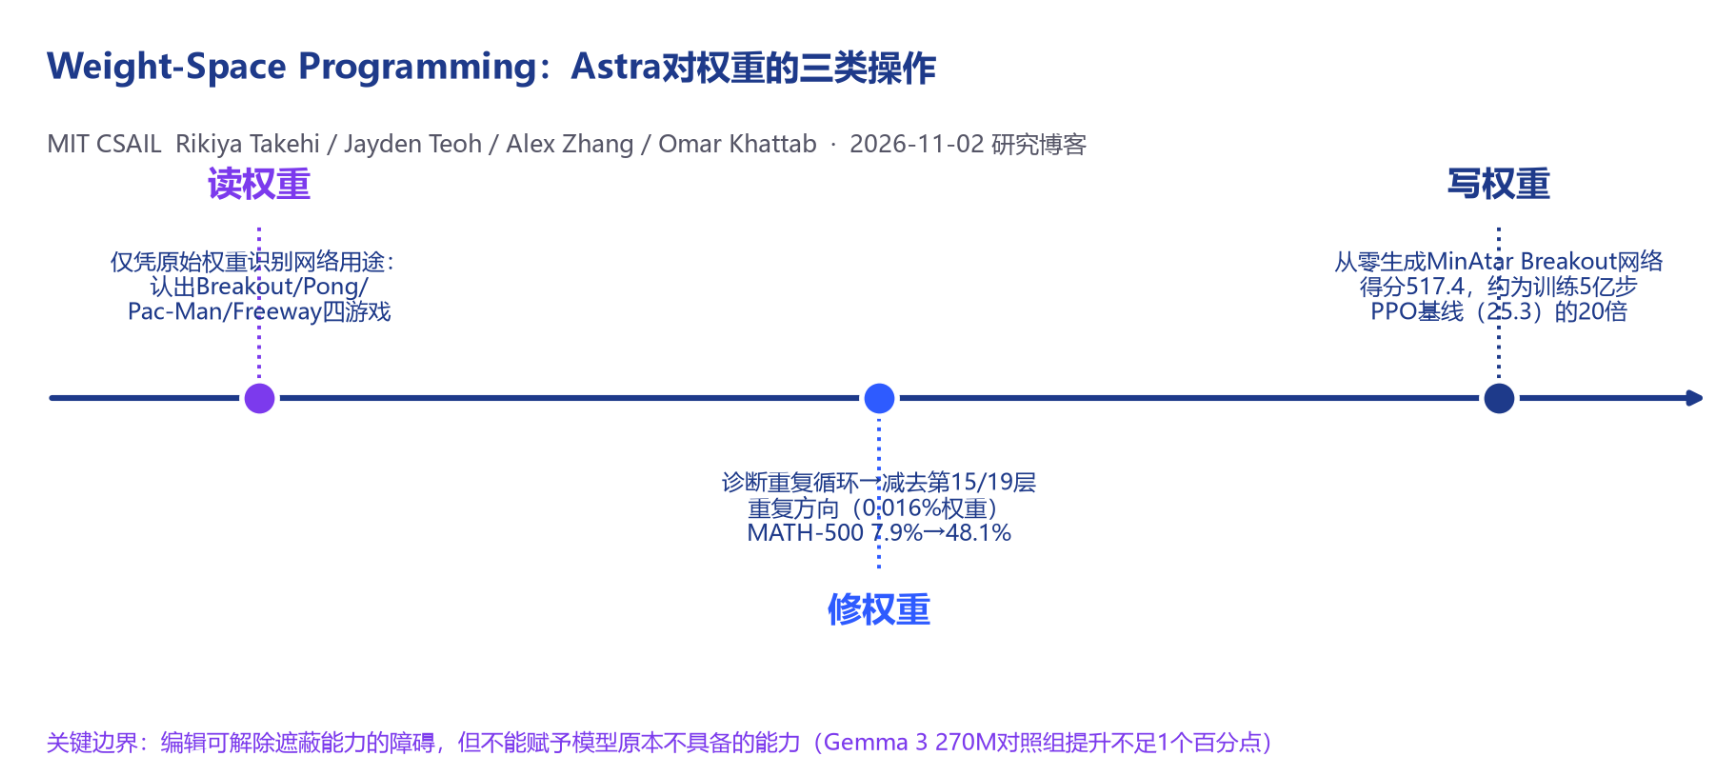
图3 Weight-Space Programming三类操作脉络
四、震动与警惕:行业的第一反应
这项工作公布后迅速在大模型社区引发讨论。研究者Rikiya Takehi在X平台写道:“与其训练,模型也许可以把原始权重当作可读、可编辑的代码:诊断故障并直接打补丁。”他还预测:“我们认为神经网络权重很快就会被有意对权重进行推理的大模型原生优化。”Databricks员工Yuchen Jin、Voyage AI研究员Chandan Singh等人发表了乐观评论,认为这条路线可能通向模型审计、更低成本的优化乃至递归自我改进。
警惕的声音同样明确。AI安全组织Pause AI的CEO Maxime Fournes在X上写道:“但愿这只是炒作。因为如果是真的,那将极大加速(AI)进展——这是非常坏的消息,让我们离全球性灾难更近。这是一个非常鲁莽的研究方向。”技术社区同时讨论了另一面:能够精准修补权重的系统,同样可能被用来植入更难发现的行为;模型供应链完整性与恶意权重编辑的风险被摆上台面。
从技术脉络看,对模型权重的定向修改并非全新事物:ROME(NeurIPS 2022)曾对transformer模型的事实关联做定向权重修改,MEMIT(ICLR 2023)把这类编辑扩展到批量更新数千条关联。MIT团队的不同之处在于,它用的是现成的通用前沿大模型,围绕自然语言目标跨任务地调查并设计修改——从“专用编辑方法”走向“通用权重操作者”。
五、产业观察:开源权重模型价值的重估
这组实验发生在开源权重模型生态快速扩张的背景下。近半年来,开源阵营动作密集:阿里先后开放Qwen3.8系列权重并发布多款小尺寸模型;月之暗面Kimi K3、K3.1 Pro把开源模型参数推至3万亿级,独立评测智能指数距闭源前沿仅3分;小米开源MiMo-V2.6并公开强化学习训练账单。英国《金融时报》9月的一篇报道也讨论了开放权重模型对超大规模云厂商和闭源AI实验室构成的潜在挑战。开源小模型普遍以低成本、可私有化部署见长,但也常受制于小参数量带来的能力短板。
权重空间编程如果成立,为开源小模型提供了一条新的性能修复路径:不动训练管线,直接在权重层面做定向手术。对于需要维护大量小型专用模型的企业,潜在应用包括小型专用模型维护与模型审计——例如直接从权重中发现后门或隐藏偏好。但前提条件同样清晰:组织必须能够访问模型权重,仅使用托管API服务的客户无从操作;每个补丁都需要作为新的模型版本管理,配套回归测试、意外变化检查和回滚路径。研究团队也承认,当前能力“仍受上下文长度与运行框架(harness)效率不足所限”,他们正在构建这套方法的基准测试与运行框架,希望“把目前看似黑魔法的东西变成严谨、可复现的工程学科”。
对这项成果的定位,产业界与研究团队本身都保持了克制:它目前是一项未经同行评审的概念验证,最亮眼的结果集中在单一0.8B小模型和单次运行上;换模型、换任务、换预算后能否复现,是否比传统微调更便宜、更可控,都还没有答案。但无论后续成色如何,它都指向了一个此前只存在于设想中的变化——模型权重正在从只能由优化器更新的数字,变成大模型可以阅读、讨论和编辑的另一种程序。开发者下次面对表现不佳的小模型时,可能真的会先问一句:这次,还需要重新训练,还是直接改权重就行?