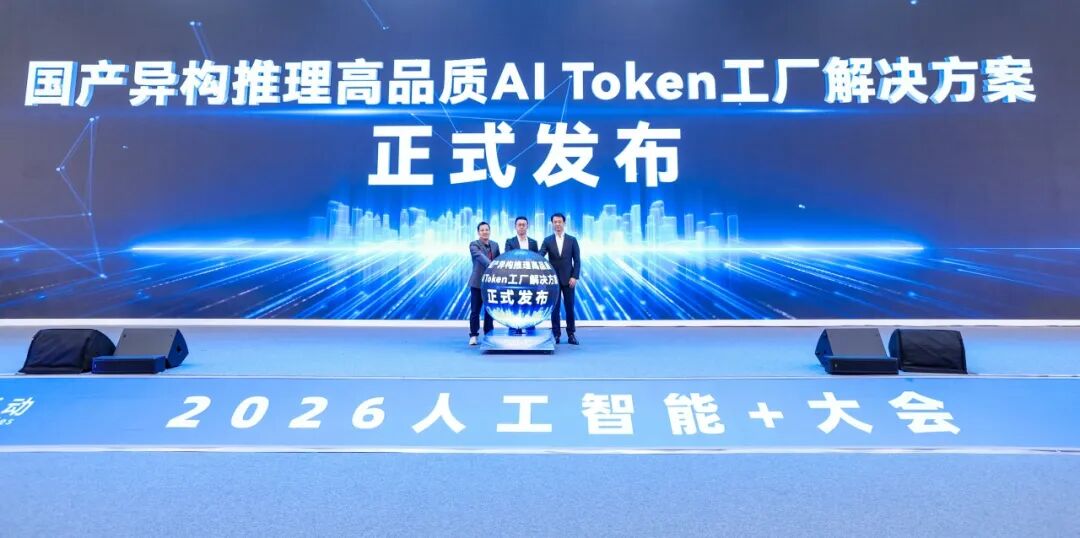
近日,在2026人工智能+大会(2026 GAI+C)上,摩尔线程联合趋境科技与智谱,正式发布“国产异构推理高品质AI Token工厂解决方案”。该方案以摩尔线程MTT S5000的高算力与全精度计算为底座,依托趋境科技全系统异构协同技术,实现推理加速,率先打通“模型-推理-芯片”产业闭环,并以底层系统工程大幅重塑“Token经济性”。
其中,摩尔线程S5000智算卡率先以芯片侧真实生产能力完成关键验证:国产算力能够在头部模型核心业务中稳定落地,整体产出性价比已超越国际先进算力。在同等硬件投入下,该方案实现有效产出成倍提升、综合成本显著降低。这一成果不仅为人工智能产业规模化落地筑牢了坚实的工程底座,更强化了北京“京模、京推、京芯”的协同布局。
PD分离异构:
生产更高品质、更具经济性的Token
人工智能产业正加速迈入“推理驱动”的新周期,基础设施的竞争需要从“单卡跑分”转向“系统级生产效率”:不仅要能稳定运行大模型,更要在既定服务目标下,让每一枚高品质AI Token的生产成本更低、产出更确定。
大模型推理并非是单一类型的计算任务。从输入理解到输出生成,推理主要经历两个核心环节:Prefill(预填充)阶段,负责快速解析上下文,要求计算密度高;Decode(解码)阶段,负责逐字输出生成,要求显存带宽充足。传统方案多由同类硬件贯穿始终,往往难以兼顾两端截然不同的计算负载特征,不仅易造成局部性能闲置,更会推高综合部署成本。
为了打破软硬件隔阂、让不同类型算力资源各展所长。此次发布的方案采用PD分离异构推理架构——摩尔线程MTT S5000负责高计算密度的Prefill阶段,而显存带宽大的算力负责Decode阶段。
具体而言,MTT S5000凭借高密度AI算力、原生FP8精度,以及MUSA完善的软件栈与生态适配能力,支持Prefill从传统推理链路中解耦,构建为可独立供给、独立计费、独立优化的算力资源池。趋境科技则通过依托PD异构推理系统实现KVCache的跨设备高效流转,最终将不同类型的算力资源整合为统一、稳定的、高性价比的端到端推理服务,从而在真实生产环境中将算力稳定转化为更高品质、更具经济性的AI Token产能。
全面投入使用,
性价比超越国际先进算力
这一国产异构方案已在生产环境全面投入使用,稳定承载头部模型企业超大参数模型,并持续承接高并发真实业务流量,实现高品质AI Token的持续供给与稳定交付。
实测数据显示,摩尔线程MTT S5000与趋境科技方案协同运行,在国产头部大模型复杂业务场景下,实现了平均超过50 TPS的生成速度、超过90%的KV Cache命中率、99.9%的稳定性,保障生产级低首Token时延。值得关注的是,在同等生产服务标准下,由3至4台MTT S5000组成的Prefill资源池,输入Token处理性价比超越国际先进算力方案。
这些关键指标验证了国产算力可以在企业核心生产环节落地,实现了企业算力投入价值的数倍释放——让同等的硬件支出可以从容承载翻倍乃至更大规模的高品质AI Token需求。它让每一元算力投入转化为更多可交付的确定性服务,也让国产旗舰模型能够在国产算力上,稳定输出复杂的长文理解与代码生成能力。
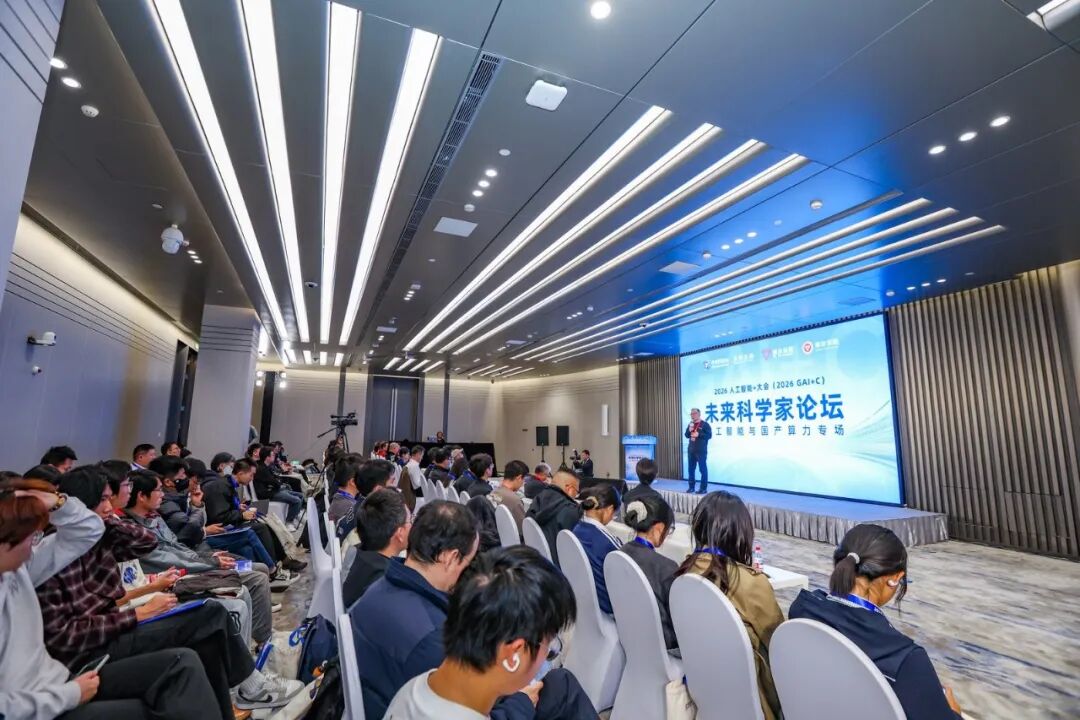
此外,在2026 GAI+C大会期间,摩尔线程还承办了未来科学家分论坛,邀请知名学者与青年科学家同台交流,分享国产算力在生命科学(AI4S)、物理智能、智慧矿井等领域的创新实践,展现摩尔线程以硬核算力赋能前沿探索、加速重大科研转化的扎实成果。