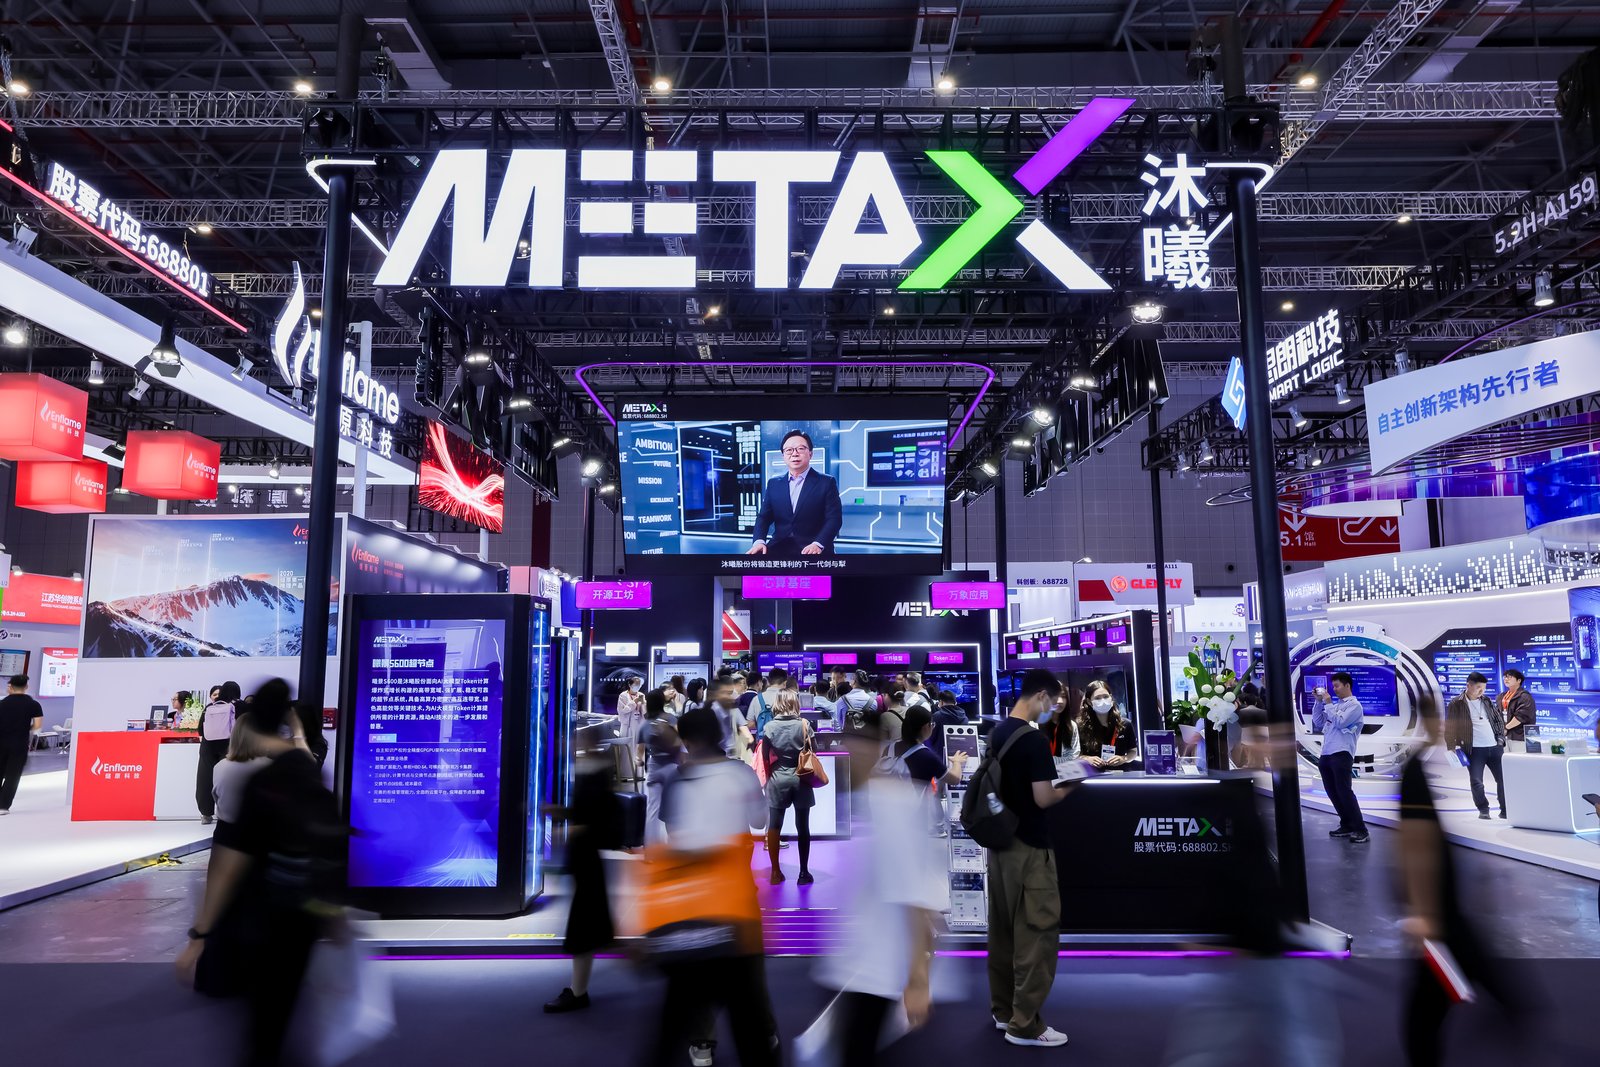
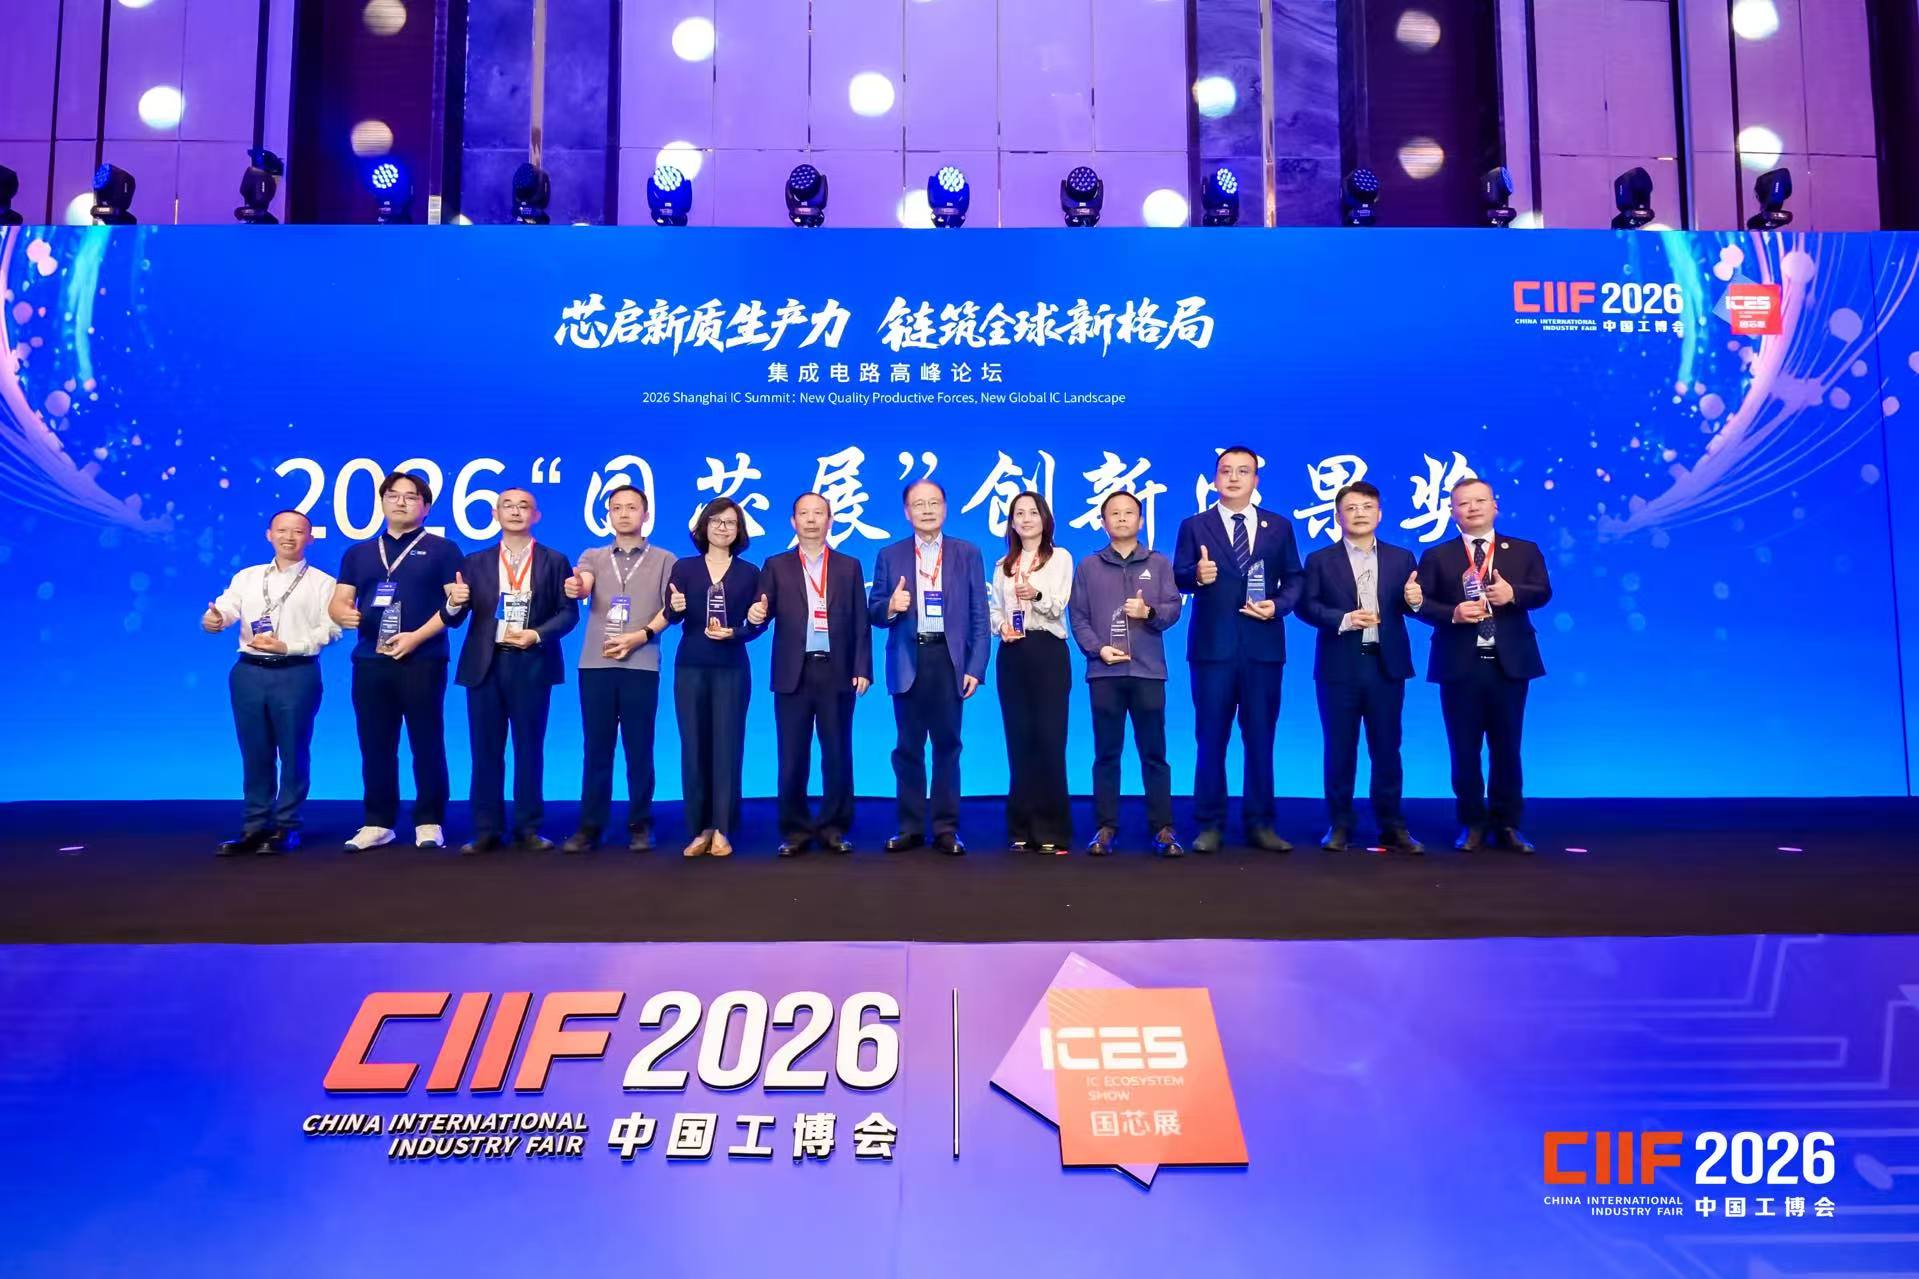
10月13日,第二届打造工业算力“芯”引擎技术研讨会在上海国家会展中心举行。沐曦股份高级副总裁孙国梁受邀发表题为《国产算力赋能下一代工业创新升级》的主题演讲,系统阐述了国产GPU在工业场景从“可用”走向“好用”的路径判断。
孙国梁指出,国产算力在工业场景的竞争力,已不再取决于单卡峰值性能,而在于“芯片+互连+存储+软件+应用”的系统组织能力。围绕这一判断,他分享了几个核心观点。
通用GPU架构是应对模型快速迭代的优势方案
孙国梁表示,B端与C端模型及Agent变化频繁,只有通用芯片架构和可伸缩节点设计才能应对未来。秉承“通用即是未来”的原则,沐曦坚持通用GPGPU路线,旗下曦思N系列、曦云C系列、曦索X系列、曦彩G系列和曦景超节点形成统一架构下的完善产品矩阵,其中,曦景超节点可实现弹性伸缩,适配工业软件系统而非单纯追求算力规模。在PD分离方面,沐曦正在推进,更长远的目标是未来P(Prefill,预填充)和D(Decode,解码)可由不同厂家的国产卡组合,完全覆盖国家工业安全、可信与数据可靠要求。
AI for Science是弥补“缺芯少魂”基础差距、弯道超车的赛道
孙国梁回顾了工业软件“缺芯少魂”的历史困境——底层芯片与上层软件均非国产,传统CAD/CAE与国际存在代差。
他认为,AI for Science的底层突破将改变上层整个工业产业链,目前中国在该领域已跑在全球第一梯队,但离国际最一流水平仍有差距。沐曦曦索X系列即是因此而生的全新系列,面向AI4S科学智能场景,提供通用高效的算力服务。
工业场景的稳定性与迁移成本是国产替代的关键门槛
针对无灯工厂、黑灯工厂对稳定性的极高要求,孙国梁介绍,沐曦在集群层面具备提高MFU、断点隔离的经验与成功案例,可实现包含电互联、光互联在内的多重模式高速互联。软件生态方面,MXMACA软件栈兼容国际主流生态,凭借全自研综合优势,支持全面平替国际主流GPU,目标实现一键迁移、开箱即用、模型预装、全兼容,让工业场景沉淀的历史代码即插即用。数据显示:截止目前沐曦MXMACA软件栈已通过6000+热门项目测试。
具身智能的工业ToB落地优先于C端
孙国梁观察到,工博会上多家具身智能企业将工业ToB场景视为未来发展最重要一环。他提出云边端协同架构方案:云端是机器人的指挥部和大脑,端侧是信息收发与感知聚集端,边缘侧是实施主体。沐曦已在基础模型、并行仿真、机器人中间件、世界模型训练推理等领域完成大量基础工作,并与国内头部机器人厂商成立合资公司,研发机器人具身大脑芯片,面向实时工业级场景。
国产GPU产业聚焦工业真场景、技术真痛点、落地真方案,GPU只是其中重要的一环,还需全产业链协同。沐曦股份已与多家国产厂商完成适配,并推出全栈国产化国鼎一体机,用于工业仿真加速与CAD/CAE开发。他表示,沐曦将坚持开源开放,推进生态投资,开放构建国家知识开放底座与工业场景开放底座,赋能各类开发者,尤其工业场景。
孙国梁预判,中国工业产线将走向全无人化、全机器人、云边端协同、模型深度优化。国产算力的真正价值,在于以系统级能力支撑这一进程,而非停留在单点性能的比拼。