导语: 10 月,Google DeepMind 的 Gemini 4 Argon 在被称为"AGI 终极考场"的交互式推理基准 ARC-AGI-3 上拿下 97.5%,成为继 OpenAI 之后第二家突破 95% 关口的实验室。但细看成绩单底部的一行小字——97.5% 属于 Provider Adapter 环境,同一模型在 Standard 环境下只有 49.8%——你会发现,这场考试真正的"隐形主考官",或许不是模型,而是评测框架本身。
一、事件全景:第二家破 95% 的实验室诞生
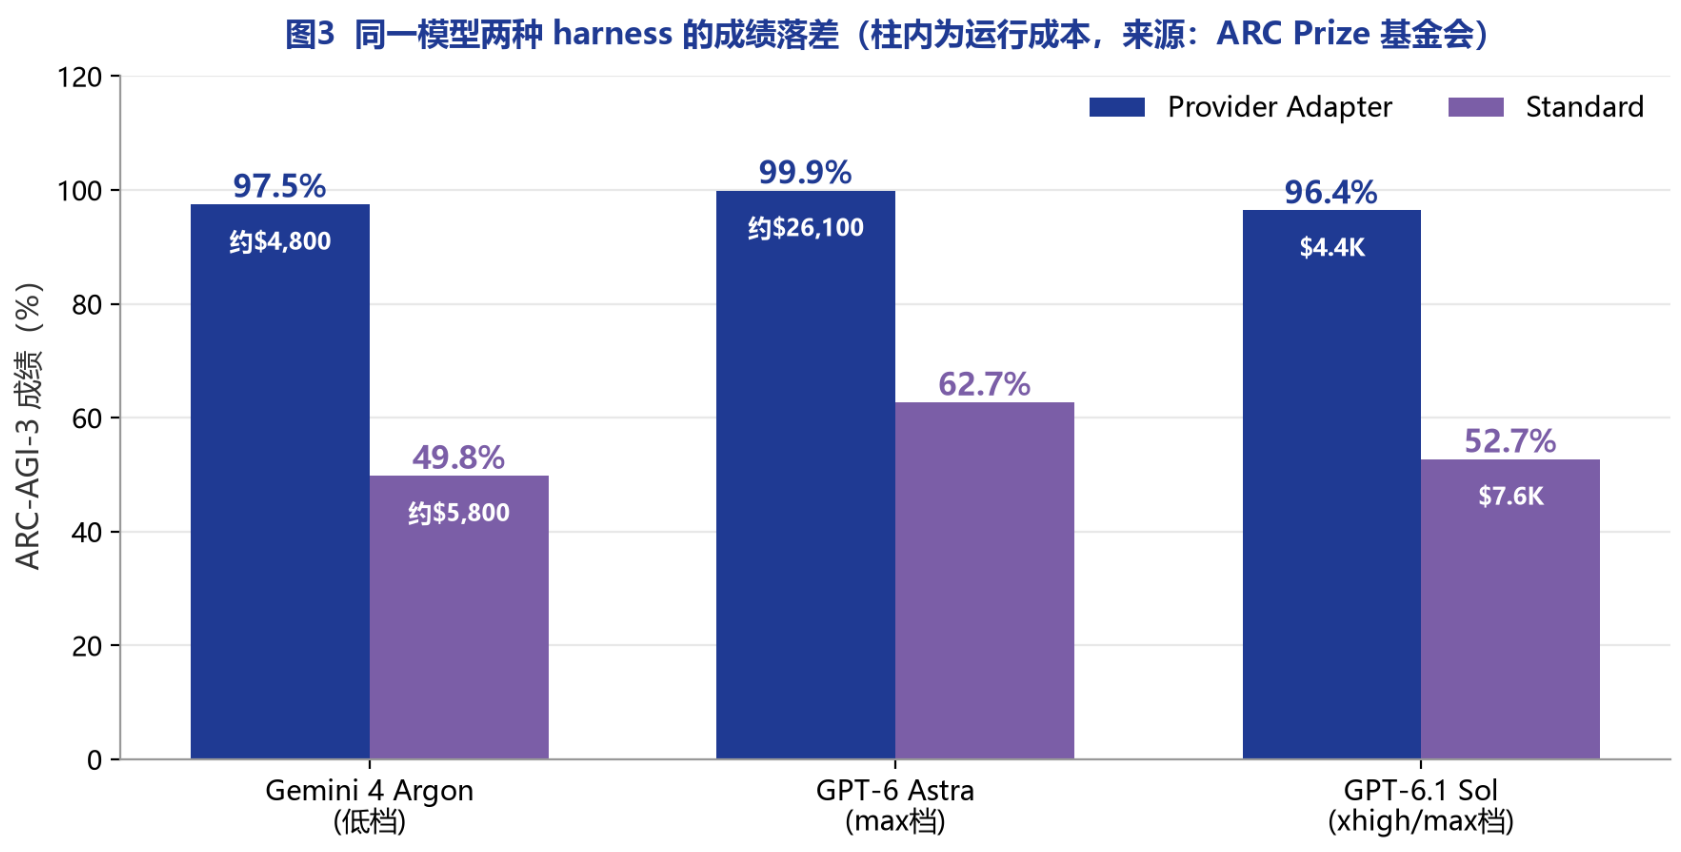
ARC-AGI-3 排行榜上,Argon 以 97.5% 的成绩位列 Provider Adapter 榜第二,仅次于 OpenAI GPT-6 Astra 的 99.9%。这一成绩由 Provider Adapter 低推理档取得,中档与高档推理配置均为 97.3%,整套考程成本约 4,800 美元(精确值 4,770 美元)。
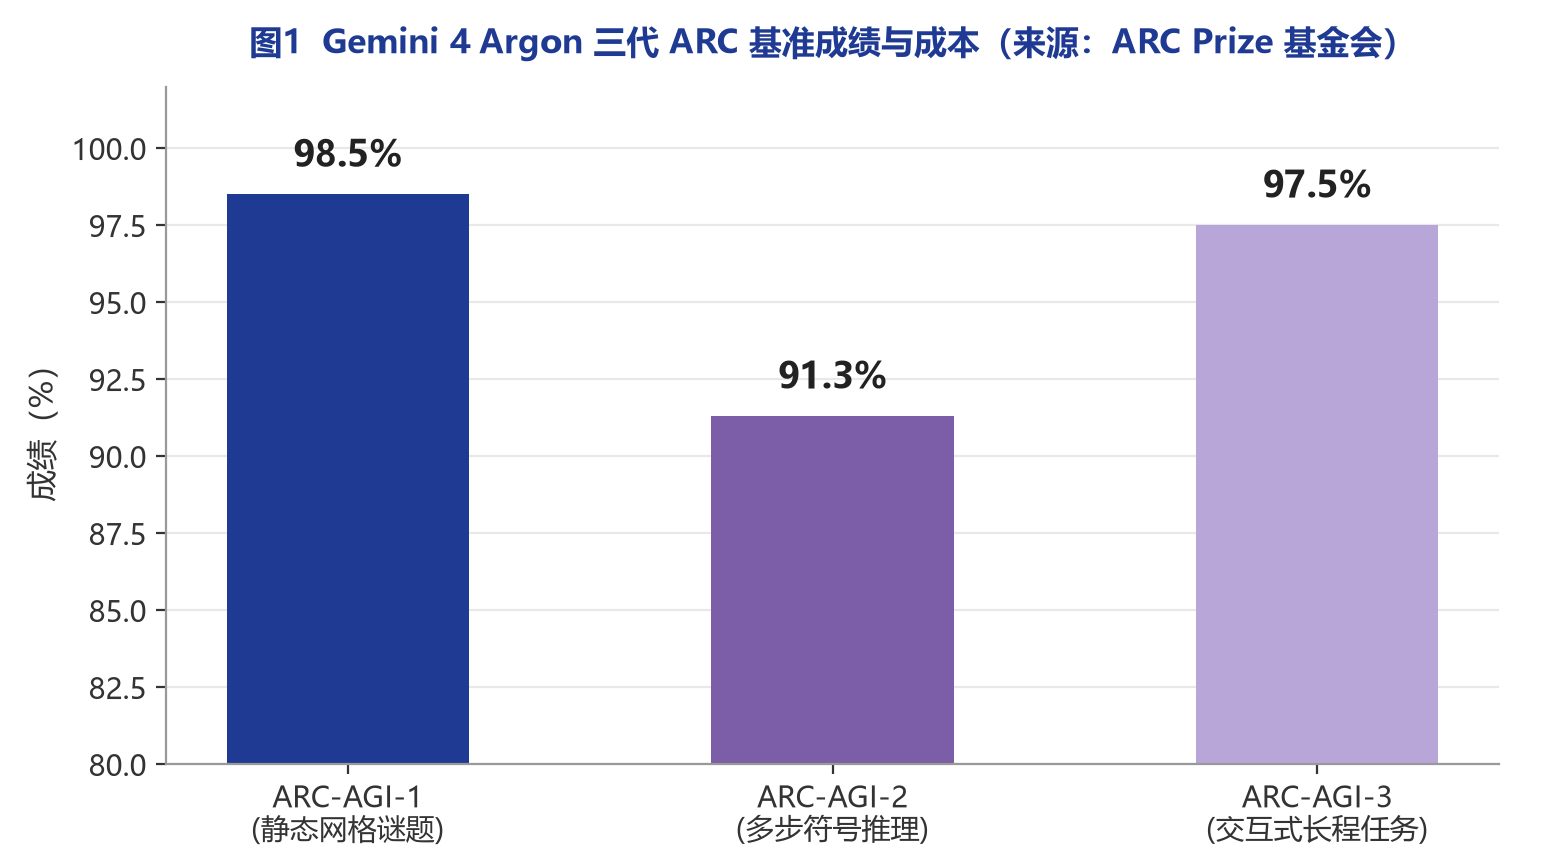
Argon 并非"偏科生"。它的三代 ARC 基准成绩单如下:ARC-AGI-1 拿下 98.5%(单题成本 0.16 美元)、ARC-AGI-2 拿下 91.3%(单题成本 0.32 美元)、ARC-AGI-3 拿下 97.5%(整套约 4,800 美元)。三代考题通杀——静态网格谜题、多步符号推理、交互式长程智能体任务,Argon 全部站上了头部位置。
从模型本身看,Argon 于 2026 年 9 月 30 日发布,是 Gemini 4 系列的首个模型,主打长复杂工作流场景——软件工程、企业知识工作与网络安全防御,输出 token 上限达 100 万,API 限时半价。在第三方评测 Epoch AI 的 ECI 指数中,Argon 拿到 165 分,与 Anthropic 的 Claude Fable 5.1 持平,落后于 Opus 5.5 的 167 分与 OpenAI GPT-6 Astra 的 166 分;单项上,数学排第 8、软件工程排第 6(据 Epoch AI)。换言之,Argon 在通用综合榜单上尚非第一梯队之巅,却在 ARC-AGI-3 这个最刁钻的考场里冲到了 97.5%——这一反差本身就值得深挖。
值得玩味的是,据观察,成绩公布后谷歌官方未置一词。这家向来高调的搜索巨头,在自家模型刷出历史级成绩时保持了罕见的沉默。
二、七个月时间线复盘:从全员不及格到三强并立
要理解 97.5% 的分量,得把时间拨回七个月前。
2026 年 3 月 25 日,ARC Prize 基金会正式发布 ARC-AGI-3——首个交互式推理基准,发布地选在 YC 总部,由 François Chollet 与 Sam Altman 对谈揭幕。上线当日,全球前沿模型全军覆没:Gemini 3.1 Pro Preview 0.37%、GPT-5.4 High 0.26%、Claude Opus 4.6 Max 0.25%、Grok-4.20 Beta 0.00%——而人类基线是 100%。
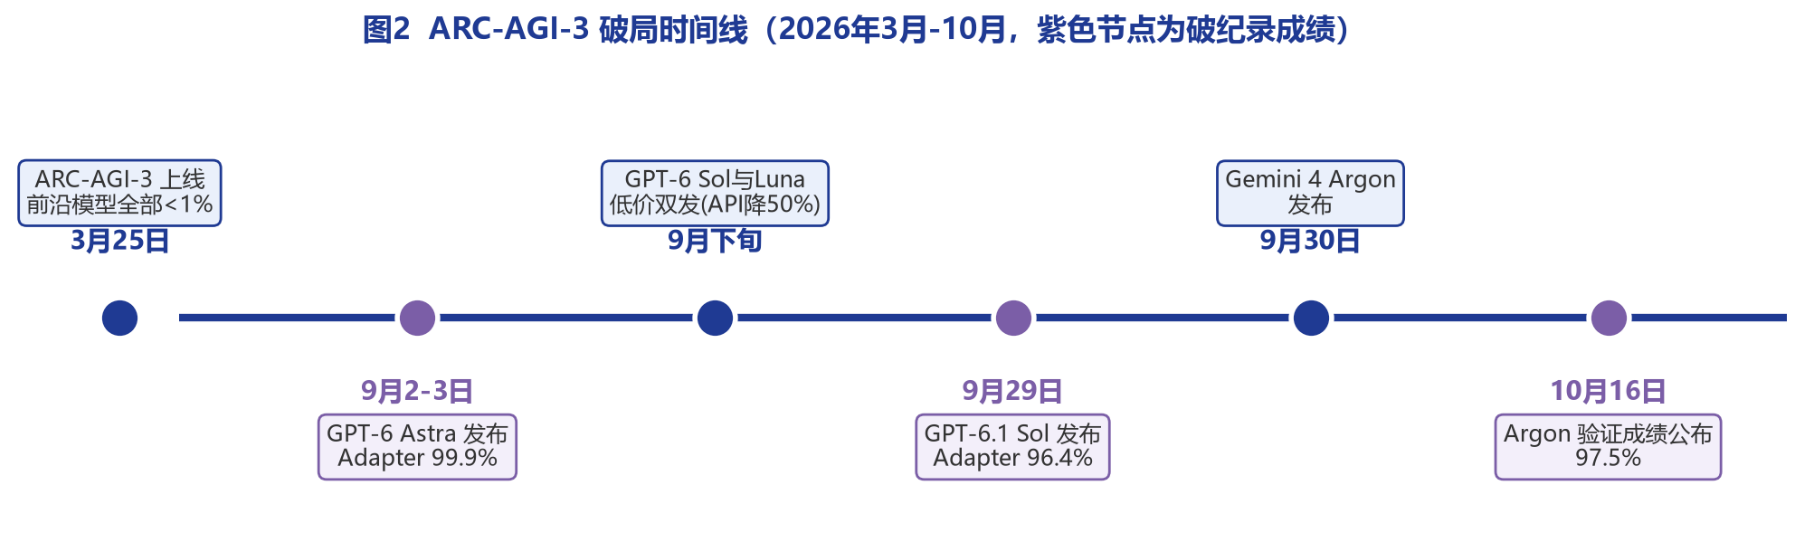
第一个打穿考场的是 OpenAI。9 月 2 日至 3 日,GPT-6 Astra 发布,在 Provider Adapter 环境拿下 99.9%(高档推理),Greg Brockman 难掩兴奋,写下"欢迎来到 AGI 时代"。不过同一模型在 Standard 环境的 max 档只有 62.7%,max 档成本约 26,100 美元。
紧接着,OpenAI 于 9 月下旬开启 GPT-6 Sol 与 Luna 的低价双发(API 降价 50%),Sol 在 9 月 29 日正式发布:Provider Adapter xhigh 档 96.4%(成本约 4,400 美元),ARC-AGI-2 上 94.2%(0.25 美元/题)、ARC-AGI-1 上 98.5%(0.06 美元/题)。96.4% 已十分接近 Astra 的 99.9%,但成本低了 77%。当然,因安全顾虑,OpenAI 取消了 GPT-6.1 Astra 的后续计划。
然后就是 10 月的 Argon:三代考题通杀,成本却只有 Astra 的零头。七个月,ARC-AGI-3 从"无人能解"走到"三强并立"——AI 能力的爬坡速度,快过了基准设计者最激进的预期。
三、ARC-AGI-3 考什么:无说明书的交互式考场
ARC-AGI-3 到底难在哪?答案是:它把模型扔进一个"没有说明书的游戏机"。
这是一系列交互式回合制游戏:无说明书、无预设指令、甚至不告知目标,模型必须自己试错、自己总结规则、自己发现通关路径。考场是一块 64×64 的彩色格子画布(每格 16 种颜色),操作界面只有 7 个动作按钮——5 个功能键、1 个撤销键,外加可选的坐标点击。
题库共 135 个手工环境,分为三层:25 个公开演示、55 个半私有评测环境、55 个全私有竞赛环境——公开练手、半私有评分、全私有决胜,最大限度防止模型"背题"。ARC Prize 2026 总奖金超过 200 万美元,其中 ARC-AGI-3 赛道大奖 70 万美元,提交截止 11 月 2 日,结果 12 月 4 日公布。
它测的不是知识,而是"流体式自适应效率"——面对全新环境,用多少步、多少成本学会并通关。这正是它区别于 ARC-AGI-1(静态网格谜题)与 ARC-AGI-2(多步组合与符号操作)的核心。3 月发布时,这个考场被视作对前沿模型的"降维打击";而到 10 月,顶级模型已接近通关。基准的"保质期"从未如此短暂。
顺带一提,框架的影响力已被学术界量化验证:2026 年 10 月,何恺明团队的 VISTA 多模态 Harness 框架,让 Claude Opus 5 在 25 个公开游戏上的分数从 40.68 分跃升至 100 分,让 GPT-5.6 Sol 从 13.33 分升至 99 分(注:百科口径)。换一个"考场服务台",分数可以直接翻倍——这为下文的争议埋下伏笔。
四、一行小字里的 48 个百分点:评测框架才是隐形主考官
Argon 成绩单上最刺眼的一行小字,是同一个模型在不同评测环境下的断崖差:
配置 | 环境 | 成绩 | 成本 |
低推理档 | Provider Adapter | 97.5% | 约 $4,800(精确 $4,770) |
中推理档 | Standard | 46.3%(55 局完成 46 局) | 约 $6,180 |
低推理档 | Standard | 49.8%(55 局完成 42 局) | 约 $5,800 |
高推理档 | Standard | 未公布(因 API 问题仅完成 19 局) | — |
同一模型,两个环境,差距近 48 个百分点。
两者的差别在于官方定义:Standard harness 只允许模型在各回合之间携带其选择保留的简单笔记(notes),回合结束后丢弃内部推理;Provider Adapter 则保留模型的不透明推理状态(retained reasoning)并支持长对话压缩(compaction),可复用先前工作。说通俗点:Standard 模式下模型每回合都要"失忆重来",Adapter 模式下模型可以"记着草稿继续算"。
成本上更出现倒挂:Standard 低档比 Adapter 低档贵约 20%,分数却不到一半(49.8% vs 97.5%)。Astra 身上同样存在这条鸿沟——Adapter 99.9% 与 Standard max 62.7% 之间差 37.2 个百分点。
这场"考务之争"并非新事。今年 7 月就曾爆发争议:GPT-5.6 Sol 在标准环境只有 7.8%——因为其回合后丢失推理、使用旧接口;切换到 OpenAI Responses API 后飙升至 38.3%,一举反超 Opus 5 的 30.2%。OpenAI 当时主张"基准必然同时测试技术环境",Chollet 随后开放双轨制,Adapter 与 Standard 并列展示。
榜单细则也值得细读:只展示成本低于 1 万美元的系统;未完成的输出记错误分;部分覆盖的成绩仍按全部任务作分母计算分数、成本仅计入已记录用量。换句话说,你在榜单上看到的每一个百分数,都是"模型 × harness 系统"的联合成绩。
五、效率维度:比人类少 62% 的行动次数
如果说 97.5% 衡量的是"能不能通",那效率维度衡量的是"怎么通的"——而这或许更能说明问题。
在 25 个公开游戏中,Argon 的通关行动次数比人类基线少 62%;Astra 同样比人类基线少 62%。更惊人的是:Argon 在 3 局中追平甚至超越了人类的速通纪录,另有 6 局与人类纪录的差距小于 10%。模型不只是在蛮力试错,它在许多关卡上找到了比人类玩家更"聪明"的路径。
ARC Prize 联合创始人 Mike Knoop 指出,Argon 是第二个通过 Provider Adapter"有效最大化"ARC-AGI-3 的模型家族,其行动效率曲线出现了"反向弯曲"——随着尝试推进,行动次数不增反降。
Chollet 的评语则带着久违的火药味:Argon 的表现特征与 Astra 相似,"Google is back at the frontier"——谷歌回到了前沿。要知道,3 月榜单垫底名单里还有 Gemini 3.1 Pro Preview 的 0.37%。七个月,从考场弃子到并列领跑,"回到前沿"四个字分量十足。
六、竞争格局重绘:三强榜、缺席者与另一张榜单
截至 10 月 18 日,Provider Adapter 榜共收录 65 个配置,头部格局清晰:
OpenAI GPT-6 Astra:high 档 99.9%(max 98.6%、xhigh 98.4%、medium 98.4%、low 98.0%)
Google Gemini 4 Argon:low 档 97.5%(high/medium 97.3%)
OpenAI GPT-6.1 Sol:xhigh 档 96.4%(max 96.2%)
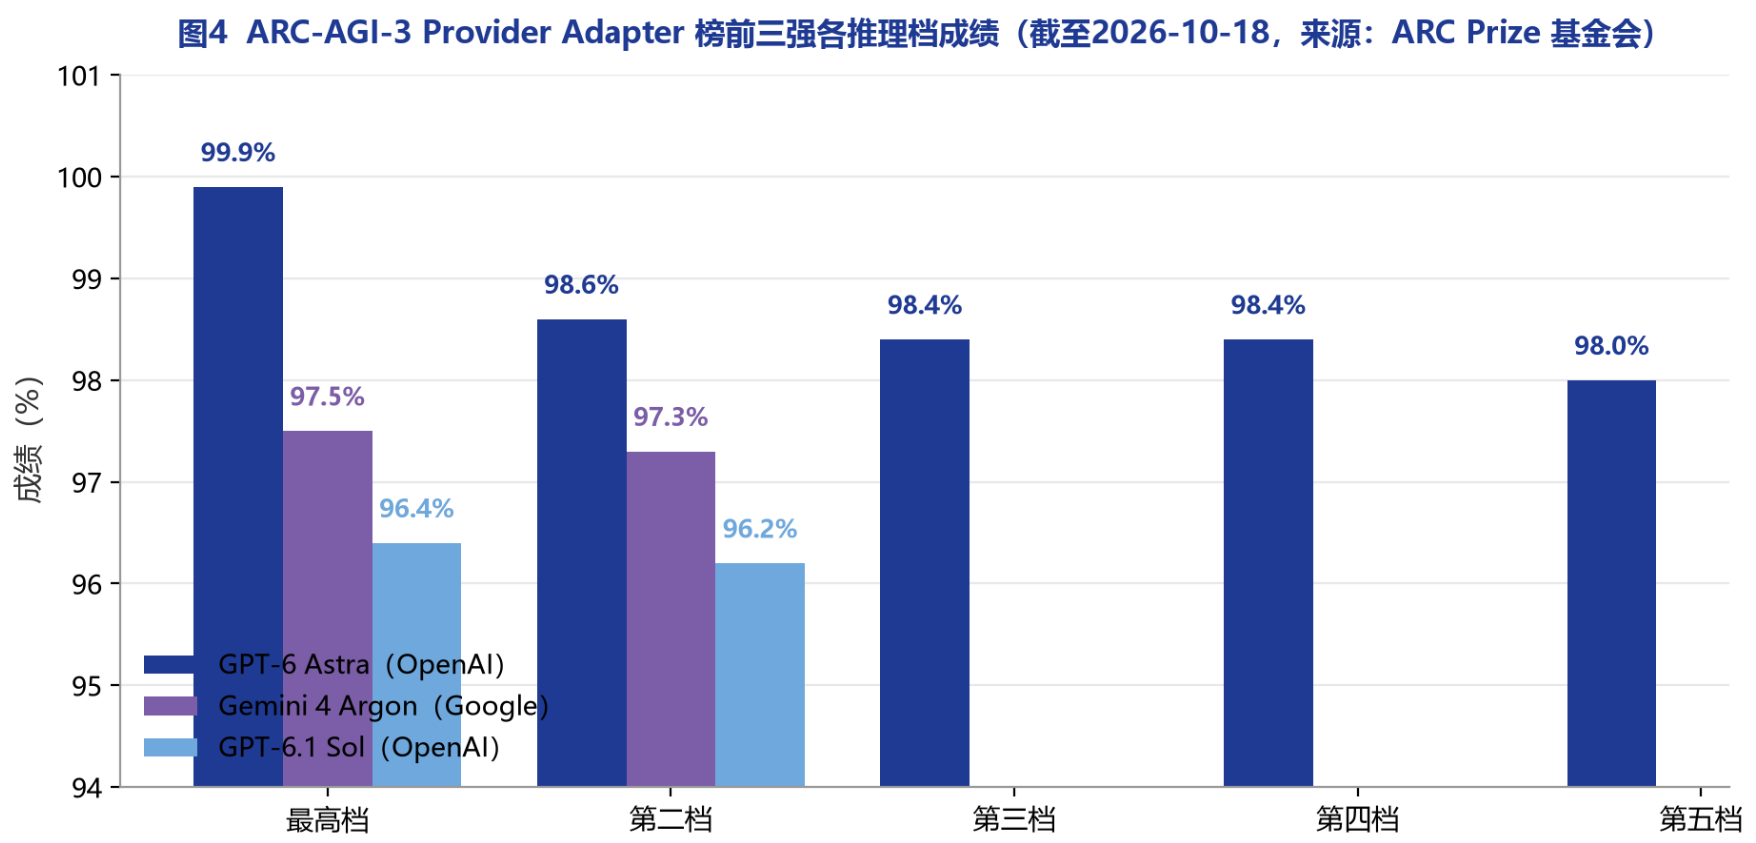
但把镜头切到 Standard 榜,画风骤变:Argon 的 49.8% 只排第五,落后于 Astra 的 max 62.7%、xhigh 59.3%、high 54.8%,以及 Sol 的 max 52.7%。同一批模型,换一张榜单,座次重排——这正是"评测框架即主考官"最直观的注脚。
值得注意的还有 Anthropic 的缺席。其最佳成绩是 Claude Opus 5 在 Standard 环境的 30.2%,旗舰 Opus 5.5 甚至没有 ARC-AGI-3 成绩。在 ARC-AGI-2 上,Opus 5.5(high)为 93.3%(0.41 美元/题),Argon 的 91.3% 落后于 Astra 的 max 95.0% 与 Sol 的 max 94.2%。回到 ECI 通用指数,Opus 5.5 仍以 167 分居首。Anthropic 的失声更多是"未应考",而非"考不动"。
外围同样热闹:OpenAI 9 月下旬 GPT-6 Sol 与 Luna 低价双发、API 降价 50%;Anthropic 完成两万亿美元估值的 IPO;Meta 于 10 月 13 日发布 Muse Wonder 系列迎战。三强之外,牌桌上的玩家都在重新算账。
七、尺子快不够用了:当"模型+harness"成为评测新范式
ARC 系列三代基准的演进,本身就是一部 AI 能力压缩史:
ARC-AGI-1(2019):源于 Chollet 的论文《On the Measure of Intelligence》,静态网格谜题;
ARC-AGI-2(2025 年 3 月推出):引入多步组合与符号操作;
ARC-AGI-3(2026 年 3 月 25 日):交互式长程智能体行为,测"流体式自适应效率",以人类效率为满分标尺。
ARC Prize 官方的立场值得全文引用式地记住:高分不等于 AGI 到来——"智能在于高效而非穷举",满分的定义是以人类效率通关每一局。97.5% 不是 AGI 宣言,而是"距离人类效率标尺还有一步"的度量。
但比分数更重要的信号是:基准正在被"模型+harness 系统"取代,成为评测的基本单元。行业旁证比比皆是——YC 的判断是"Harness 比模型更重要";南洋理工大学安波团队专门开展 Agent Harness 研究;MLPerf Inference 已迭代至 v6.1;评测平台 Arena 完成两亿美元 B 轮融资,估值 31 亿美元。评测正在从"考试的旁支"变成"产业的主赛道"。
由此,给所有读榜人立三条新规则:
1. 先看环境再看分数——同一个模型,Provider Adapter 与 Standard 的差距可达近 48 个百分点,只报一个数字的都是断章取义;
2. 成本是第二坐标轴——Argon 以约 4,800 美元做到 97.5%,Astra 以约 26,100 美元做到 99.9%,Sol 用 Astra 零头 23% 的价格逼近其成绩;效率与成本,比孤立的最高分更能说明商业现实;
3. 榜单是快照不是结论——双轨制、未完成记错误分、按全部任务计分等细则,决定了每个百分数的含义都藏在脚注里。
ARC-AGI-3 用七个月走完了前辈们数年的"失效周期"。当尺子的寿命短于模型的迭代周期,真正的竞赛已经不在考场上,而在设计下一把尺子的能力上。Chollet 们必须跑得更快——因为模型,已经追到了考官身后。