10月19日晚,通用人工智能公司 MiniMax 正式发布新一代 Flash 模型 M3.1 Flash,并同步认领了近一个月来在开发者社区刷屏的匿名模型“太空兔”(Space Bunny)。官方确认,匿名运行期间处理了超过200万亿 Token 的 Space Bunny,正是 M3.1 Flash 的早期版本;该模型9月下旬在 OpenRouter、OpenCode 匿名上线后,3天内登顶两个平台的 Token 日调用量榜首。据官方披露,M3.1 Flash 在智能体(Agent)任务、编程、电脑操作(Computer Use)及网络安全等能力上实现“代际提升”,线上推理速度提升近3倍,智能体类任务综合使用成本较前代降低70%,API 价格较前代下调约一半。目前该模型已通过 MiniMax API、M Plan 与 MiniMax Code 三个渠道上线,模型权重计划于近期开源。
一、“太空兔”归巢:一场持续近一个月的匿名试炼
9月下旬,一款代号“太空兔”的匿名模型悄然出现在 OpenRouter 与 OpenCode 平台。凭借“爆发式推理速度、强编码能力、原生多模态输入”以及高达100万 Token 的上下文窗口,它在上线3天内便登顶两个平台的 Token 日调用量榜首,与 DeepSeek V4.1 Flash、GLM 5.3 Flash 一同占据调用量前三名。开发者社区一度对其真实身份猜测纷纷,多家机构将其与 MiniMax 联系在一起。
MiniMax 的“认领”节奏颇具戏剧性。10月19日下午,MiniMax 官方账号发布一段“胡萝卜造型火箭点火升空”的短视频,配文“Welcome back, Space Bunny”,被市场视为官方认领的信号;当晚,M3.1 Flash 正式发布,官方证实 Space Bunny 正是该模型的早期版本,其匿名运行期间处理了超过200万亿 Token,相当于对模型进行了一次真实流量下的极限压力测试。
从营销视角看,匿名发布制造悬念、用实测数据说话,最终以“认领”完成声量闭环;从工程视角看,超200万亿 Token 的真实推理负载,也为模型在速度、稳定性与成本上提供了难以复制的验证样本。事实上,M3.1 Flash 的预览版(M3.1-Flash-Preview)自9月底起已在 MiniMax Code 工具内先行开放,供开发者用于高频编码与科研类任务,其“百万级上下文加稀疏注意力”的底牌早已在技术社区流传。
二、能力跃迁:从 Agent 到网络安全的代际提升
按照 MiniMax 的定位,M3.1 Flash 是面向 Coding 与 Agent 场景优化的轻量级模型。与旗舰 M3 相比,它在保持多模态能力的基础上,通过“更激进的稀疏注意力架构”进一步压缩推理成本,并维持最高100万 Token 的上下文窗口。官方公布的多项基准数据,展示了其能力站位。
表1 M3.1 Flash 主要基准成绩与对比
评测基准 | M3.1 Flash | 表内最高成绩 | 考察内容 |
AutomationBench v1.0.6 | 62.2 | 62.2(本表最高) | 600个企业工作流任务,跨SaaS系统端到端执行 |
BankerToolBench | 76.2 | 76.2(与Claude Opus 5并列) | 多步规划、跨文档一致性、金融合规、连续工具调用 |
DeepSWE v1.1 | 73.7% | 77.0%(DeepSeek) | 完整软件开发流程:理解、开发、修复、测试验证 |
OSWorld 2.0 | 61.7 | 70.6(Claude Opus 5) | 电脑操作与跨应用任务执行 |
Agents’ Last Exam | 29.6 | 32.2(Claude Opus 5) | 真实职业任务,具经济价值 |
CyberGym | 82.2 | 84.5(GLM-5.3) | 漏洞发现与验证 |
LOCA-Bench 256K | 60.3 | 60.3(本表最高) | 超长上下文可控测试 |
在智能体任务方面,M3.1 Flash 在 AutomationBench v1.0.6 中取得62.2分,高于 DeepSeek V4.1 Flash-1017 的60.5分,在参与对比的模型中位列第一;该测试基于600个真实企业工作流任务,考察模型跨 SaaS 系统完成销售、营销、运营、客服、财务、人事等端到端工作的能力。在考察多步规划、跨文档一致性、金融合规与连续工具调用的 BankerToolBench 中,其得分76.2,与 Claude Opus 5 并列。
软件开发方面,M3.1 Flash 在 DeepSWE v1.1 中取得73.7%,接近 Claude Opus 5 的74.0%、高于 GPT-5.6 Sol 的73.0%,低于 DeepSeek V4.1 Flash-1017 的77.0%。电脑操作方面,其在 OSWorld 2.0 中取得61.7分,在聚焦真实经济价值任务的 Agents’ Last Exam(ALE)中取得29.6分,两项成绩均为国产模型第一。网络安全方面,CyberGym 得分82.2,高于 Kimi K3 的80.0;MiniMax 称内部安全专家进一步对代码审计、漏洞修补、渗透测试、恶意软件分析、逆向工程等场景做了深度评测,模型表现均“出色”。
技术路线的演进为能力跃迁提供了注脚。MiniMax 在2026年6月发布并开源旗舰模型 M3 时,首次落地自研 MSA(MiniMax Sparse Attention)稀疏注意力架构,实现在100万 Token 上下文下每 Token 计算量约为上一代的二十分之一、解码阶段显著加速;M3.1 Flash 则在此基础上采用更激进的稀疏化策略,把“效率优先”推向新高度。
三、效率与成本经济学:200+TPS 与“斩腰”价格
速度与成本是本轮发布的核心卖点。官方数据显示,M3.1 Flash 在日常使用场景下输出速度可达200+ TPS(每秒 Token 数),中位数(P50)稳定在170+ TPS;线上推理速度较前代提升近3倍。
价格方面,M3.1 Flash 的 API 定价为每百万 Token 输入1元、输出4元、缓存读取0.1元(官方美元口径为每百万 Token 输入0.15美元、输出0.60美元、缓存读取0.015美元)。与上一代 M3 相比,输入、输出单价均下调50%以上,缓存读取单价下调超70%;在 Agent 类任务中,综合使用成本较前代降低70%。
MiniMax 还给出了任务级成本账本:在 Automation-Bench 上,随着推理档位从 low 提升至 max,M3.1 Flash 的成绩从52.8%升至62.8%,平均每项任务成本约为0.18元至0.30元,各档位均低于 DeepSeek V4.1 Flash-1017(对比图中 DeepSeek 采用高峰时段价格,其余模型采用官方定价)。在 DeepSWE v1.1 中,其 high、xhigh、max 档位成绩分别为68.1%、72.1%、73.7%,对应平均任务成本均在2元以内;作为对照,Claude Opus 5 达到约74%成绩时,平均每项任务成本已达数十元。在 ALE 全部152个任务的 Overall 评测中,M3.1 Flash 以约739元的预计总成本取得29.6%的通过率,是图中成本最低的模型;作为对照,GPT-5.6 Sol 通过率约30.6%、预计总成本约5000元,Claude Opus 5.5 通过率约38%、预计总成本接近9000元。
“单次省下的几块钱,乘以规模就是真金白银的护城河。”当 AI 开始操作软件、编写代码、执行企业工作流,多步推理与工具调用放大了单次调用的成本差异,任务级性价比正在取代参数与榜单,成为新一轮竞争的度量衡。
四、竞争格局:国产“Flash 双子星”与任务级定价战
M3.1 Flash 的发布恰逢一场国产模型“Flash 化”竞速的高潮。10月17日,DeepSeek 将 V4.1 Flash 更新至1017快照版本,官方称其“显著增强项目开发能力,以更低成本、更快速度完成任务”;该模型基于稀疏混合专家架构、拥有百万级上下文,发布后在 Code Arena 的 WebDev 开源模型榜单登顶。更早之前,智谱 GLM 5.3 Flash、月之暗面 Kimi K3 等也已“轻量、低价、高吞吐”的姿态加入战局。
有媒体以“DeepSeek 第一,MiniMax 第二”形容两家国产模型在 Coding 性价比上的贴身肉搏:在 DeepSWE 上,DeepSeek V4.1 Flash-1017 以77.0%领先;而 M3.1 Flash 在 Automation-Bench 上反超 DeepSeek 拿下第一。两者发布时间仅隔一个周末、72小时内相继登场,被媒体称为国产“Flash 双子星”。而在匿名期,太空兔与 DeepSeek V4.1 Flash、GLM 5.3 Flash 同列 OpenRouter 调用量前三,早已提前上演了这场“效率竞赛”。
值得关注的是,本轮竞争的标尺已从“跑分”转向“单任务成本”。OpenRouter 等聚合平台上,各厂商 Flash 模型的定价透明度被进一步拉高;MiniMax 用 Automation-Bench、DeepSWE、ALE 三组“得分-成本”曲线,直接回应“模型能完成多少工作、完成这些工作需要花多少钱”的问题。可以预见,Agent 场景的规模化部署,将成为下一阶段大模型厂商争夺的核心战场。
五、商业化与战略:上市公司的 Flash/Pro 双线
MiniMax 已是一家上市公司。这家成立于2021年12月、由原商汤科技 AGI 负责人闫俊杰创办的 AI 公司,于2026年1月9日在港交所挂牌上市(股票代码0100.HK),IPO 募资约55.4亿港元,上市首日市值约719亿港元,创下全球人工智能领域从成立到 IPO 的最短时间纪录。
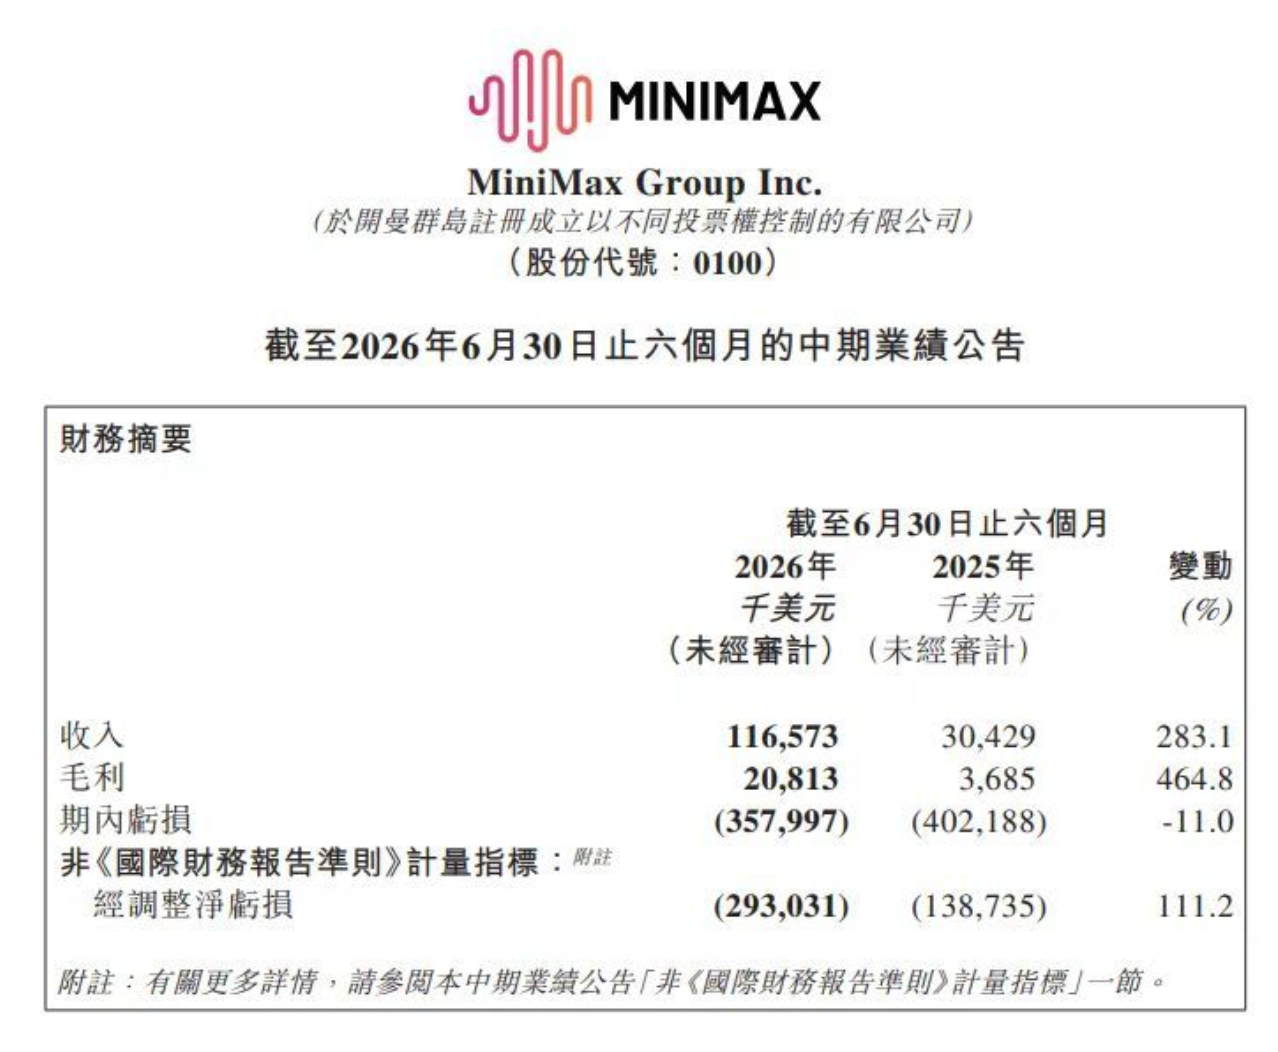
财报数据为“效率优先”的战略提供了注脚。据 MiniMax 发布的2026年中期业绩,公司上半年总收入1.166亿美元,同比增长283.1%,已超过2025年全年收入(7900万美元);其中开放平台及其他 AI 企业服务收入7390万美元,同比增长703.1%,占总营收的63.4%。在6月大幅降价与 Token Plan 推广带动下,公司 Token 消耗量快速增长,7月约为1月的20倍——模型降价与调用量增长之间形成了正向循环。
产品与生态层面,MiniMax 已形成 M 系列语言模型(M3 已开源)、H 系列视频模型,以及海螺 AI、Talkie 等组成的全模态产品矩阵,并推出面向开发者的 MiniMax Code 与订阅服务 M Plan。M3.1 Flash 发布当日,MiniMax Code 同步推出限时权益:10月25日前所有订阅用户可不限量使用 M3.1 Flash,10月31日前新订阅或升级 M Plan 的用户可享首月五折。
值得注意的是,MiniMax 在发布 M3.1 Flash 时明确预告:Flash 系列代表对效率与能力平衡的探索,主攻更高智能上限的 Pro 版本“已经在路上”。Flash 打规模、Pro 打上限的高低搭配,正在成为国产大模型厂商应对差异化竞争的共同剧本;与此同时,M3.1 Flash 的开放权重计划若如期落地,还将把价格战与生态战延伸至开源社区。
结语
从“太空兔”的匿名试炼,到 M3.1 Flash 的正式归巢,MiniMax 用一场精心编排的发布,把“Agent 性价比”推到了聚光灯下。当推理速度接近翻倍、智能体任务综合成本下降七成、单任务成本进入“元级”区间,困扰大模型落地的成本门槛正在被系统性击穿。对于开发者与 To B 客户而言,模型的“可用性”有了更清晰的定义——不是参数大小,而是“完成一件真事的成本”。这或许是本轮国产 Flash 混战最有价值的注脚:大模型行业的竞争,正在从能力之争,走向真正的规模化应用之争。